DNAStringSet object of length 2:
width seq
[1] 17 CCTAYGGGDBGCWSCAG
[2] 21 GACTACNVGGGTATCTAATCCChicken intestinal microbiota
Amostras e objetivos
Este estudo tem como objetivo compreender o microbioma de segmentos do intestino de frangos que ainda não eclodiram do ovo tratados com probióticos. A análise busca revelar as diferenças e semelhanças nas comunidades microbianas associadas a cada condição.
Pré-processamento
Nomenclatura
As amostras referentes às bibliotecas de amplicons 16S sequenciadas foram nomeadas de acordo com o padrão:
| CODE | TREATMENT |
|---|---|
| C | Control |
| V | Vehicle |
| P | Probiotic |
| A | Antibiotic |
| CODE | SEGMENT |
|---|---|
| D | Duodenum |
| J | Jejunum |
| I | Ileum |
| C | Cecum |
| CODE | SEX |
|---|---|
| M | Male |
| F | Female |
<TREATMENT><SEGMENT><SEX><BIOLOGICAL REPLICATE>
Processamento dos dados
Análise de qualidade das amostras pré-processamento
A avaliação de qualidade foi realizada com FastQC v0.11.9 utilizando os parâmetros pré-definidos (default) para as leituras R1 e R2 de cada amostra, e, por fim, os relatórios individuais foram reunidos em um relatório final com MultiQC v1.13.dev0.
Programas:
FastQC: A high throughput sequence QC analysis tool. - fastqc v0.11.9 MultiQC: Aggregate results from bioinformatics analyses across many samples into a single report. - multiqc v1.13.dev0
Resultados da Avaliação de qualidade (prévia)
Verificação dos iniciadores (primers)
O módulo search_oligodb do programa usearch v11.0.667 foi utilizado para a busca pelas sequências dos pares de oligos iniciadores (primers) utilizados na amplificação dos fragmentos. Essa busca ocorreu considerando as primeiras 500 sequências, no máximo 2 mismatches e buscando em ambas as orientações.
Programa:
USEARCH: search and clustering algorithms that are often orders of magnitude faster than BLAST. - USEARCH v11.0.667, módulo -search_oligodb.
Os primers utilizados na verificação foram:
Resultado da verificação dos iniciadores (primers)
Estimativas de tamanhos e qualidades das leituras (reads)
O módulo fastq_eestats2 do programa usearch v11.0.667 foi utilizado para a obtenção de um sumário mostrando a quantidade de leituras que passam em um filtros considerando limiares de estimativas de erros esperados (0,5, 1 e 2) em função de tamanhos de leituras (200pb a 300pb, com incremento de 10pb). Informações úteis para escolhas de parâmetros relacionados à poda de qualidade e fusão dos pares (R1 e R2) quando necessário.
O módulo fastq_eestats do programa usearch v11.0.667 também foi utilizado para a obtenção de relatórios de qualidade com estimativas de erro esperado. A documentação das colunas pode ser consultada no site do módulo.
Resultados das estimativas de tamanhos e qualidades das leituras
Estimativas das médias de erros esperados (reads)
Utilização do módulo fastx_info do programa usearch v11.0.667 foi utilizado para a obtenção da estimativa de erro médio dentro de cada biblioteca, considerando as suas reads.
Resultado das estimativas das médias de erros esperados (reads)
Podas de bases de baixa qualidade
Em seguida, as leituras foram submetidas a podas de bases com baixa qualidade com o programa fastp v0.23.2, considerando a estratégia de janela deslizante, avaliando 5 bases a partir da extremidade direita, deslizando 1 base à esquerda e podando as bases da janela se a qualidade média dessas bases estiver abaixo de 10). O programa também foi configurado para descartar as leituras com a média de qualidade das bases abaixo de 10. As podas foram feitas independentemente para as leituras R1 e R2 de cada amostra.
Avaliação de qualidade das reads posterior à etapa de poda de qualidade
A avaliação de qualidade das reads foi realizada da mesma forma como descrito anteriormente.
Resultados da avaliação de qualidade das reads após a poda de qualidade
Fusão das reads R1 e R2 em sequências de amplicons
As leituras R1 e R2 do sequenciamento foram fundidas para a representação dos amplicons. Para isso foi utilizado o programa flash v1.2.11, considerando mínimo de sobreposição de 15 bases (–min-overlap 15) e um máximo de 250 bp (–max-overlap 250), além de um máximo de falhas na correspondência de 20% (–max-mismatch-density 0.2).
Obtenção dos amplicons utilizando os primers especificados
A obtenção dos amplicons via PCR in-silico foi realizada com o módulo search_pcr do programa usearch v11.0.667. Utilizando o primer forward e o primer reverse, que permitem a captura da região V3-V4 do gene 16S rRNA. Um máximo de 5 diferenças foi considerado como uma correspondência (match) aceita entre as sequências dos primers e as sequências dos amplicons.
Quando há mais do que um amplicon por leitura, então a maior é a selecionada com in-house Perl script GetLargestAmp.pl.
Avaliação de qualidade dos amplicons obtidos após PCR in-silico
A avaliação de qualidade dos amplicons foi realizada da mesma forma como descrito anteriormente para as reads.
Resultados da avaliação de qualidade dos amplicons
Estimativas de tamanhos e qualidades das leituras (amplicons)
Procedimento realizado exatamente como descrito anteriormente para as reads.
Resultados das estimativas de tamanhos e qualidades das leituras
Estimativas das médias de erros esperados (reads)
Utilização do módulo fastx_info do programa usearch v11.0.667 foi utilizado para a obtenção da estimativa de erro médio dentro de cada biblioteca, considerando as suas reads.
Resultado das estimativas das médias de erros esperados (amplicons)
Contagens preliminares
Processamento dos Amplicons e obtenção das Amplicon Sequence Variants (ASVs)
As etapas de processamento a seguir foram realizadas no ambiente R v4.1.2.
Avaliação do perfil de qualidade das sequências dos amplicons
As leituras R1 foram carregadas no pacote DADA2 para o reconhecimento dos amplicons. Na Figure 1 a seguir temos uma análise da qualidade das leituras em função do tamanho.
Filtragem e poda de sequências de amplicons
A seguir foi realizada uma filtragem e poda nas sequências de acordo com o perfil de qualidade observado, dessa forma, consideramos não truncar as sequências até um determinado tamanho (truncLen = 0), com um valor máximo de expectativa de erros (maxEE) de 0,5, removendo amplicons provenientes do controle PhiX e as de baixa complexidade (número efetivo de kmers menor que 5). A intenção também é a de manter o máximo de leituras possível, sem a perda de qualidade.
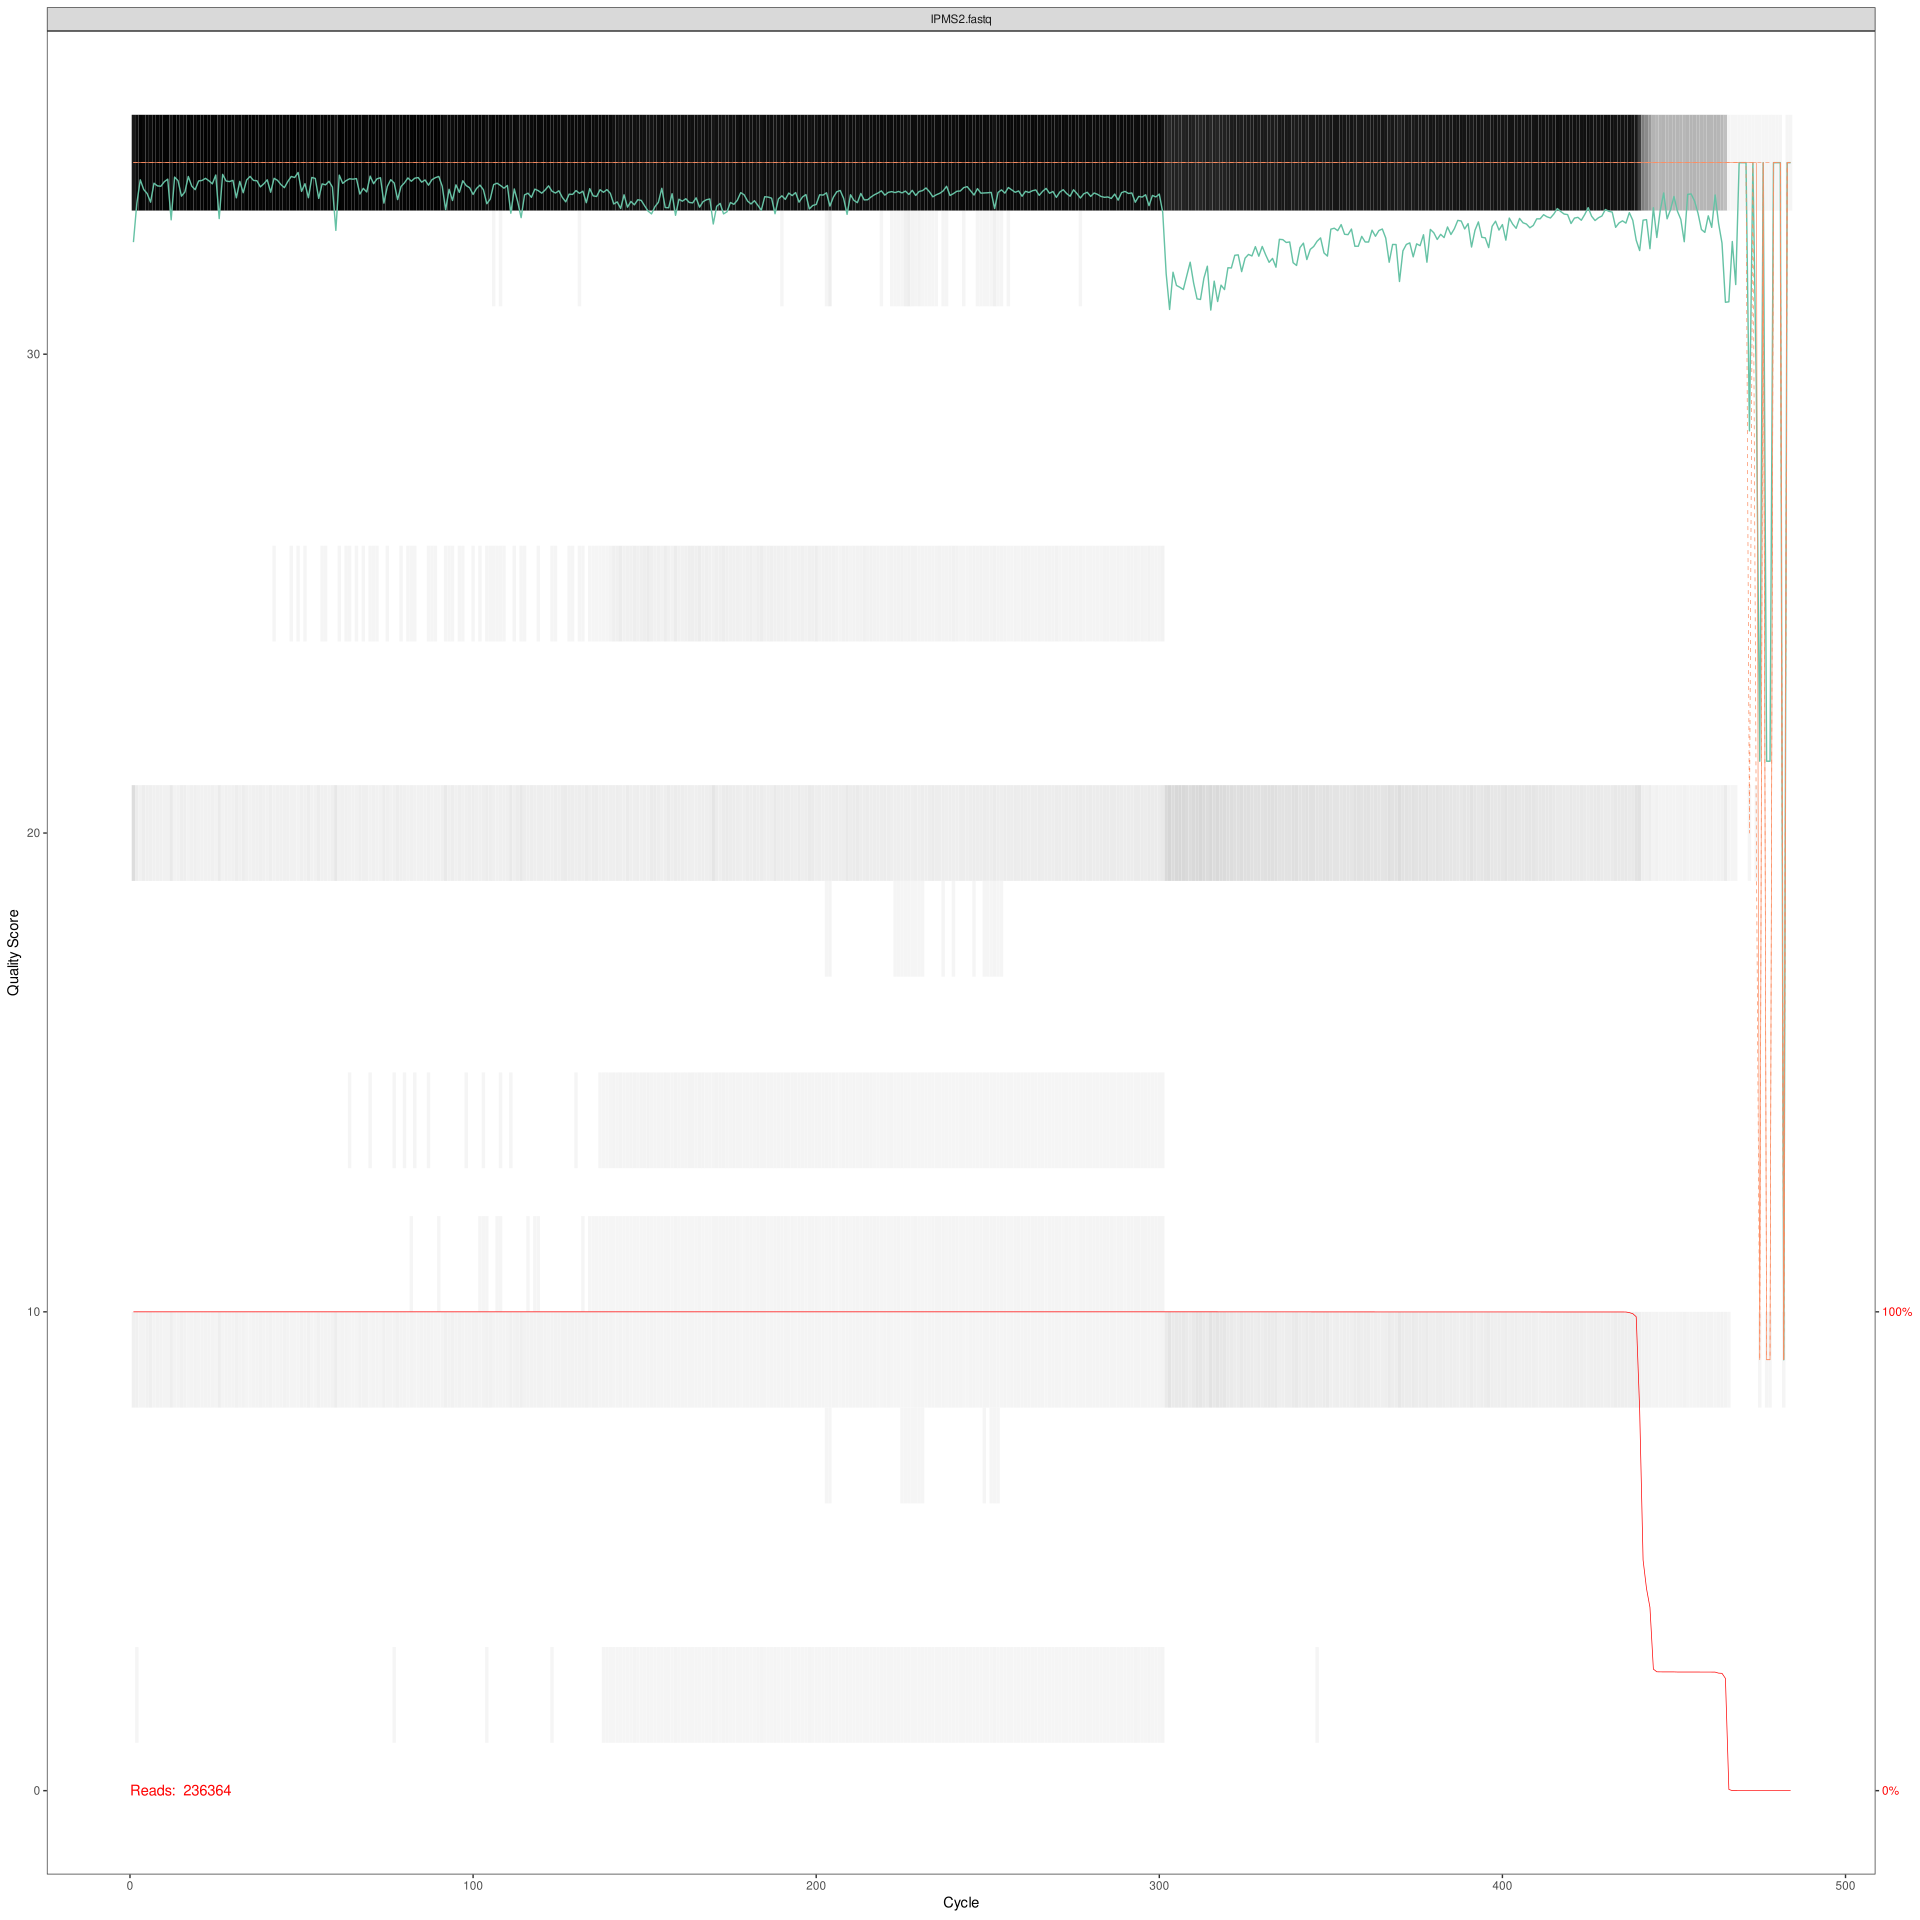
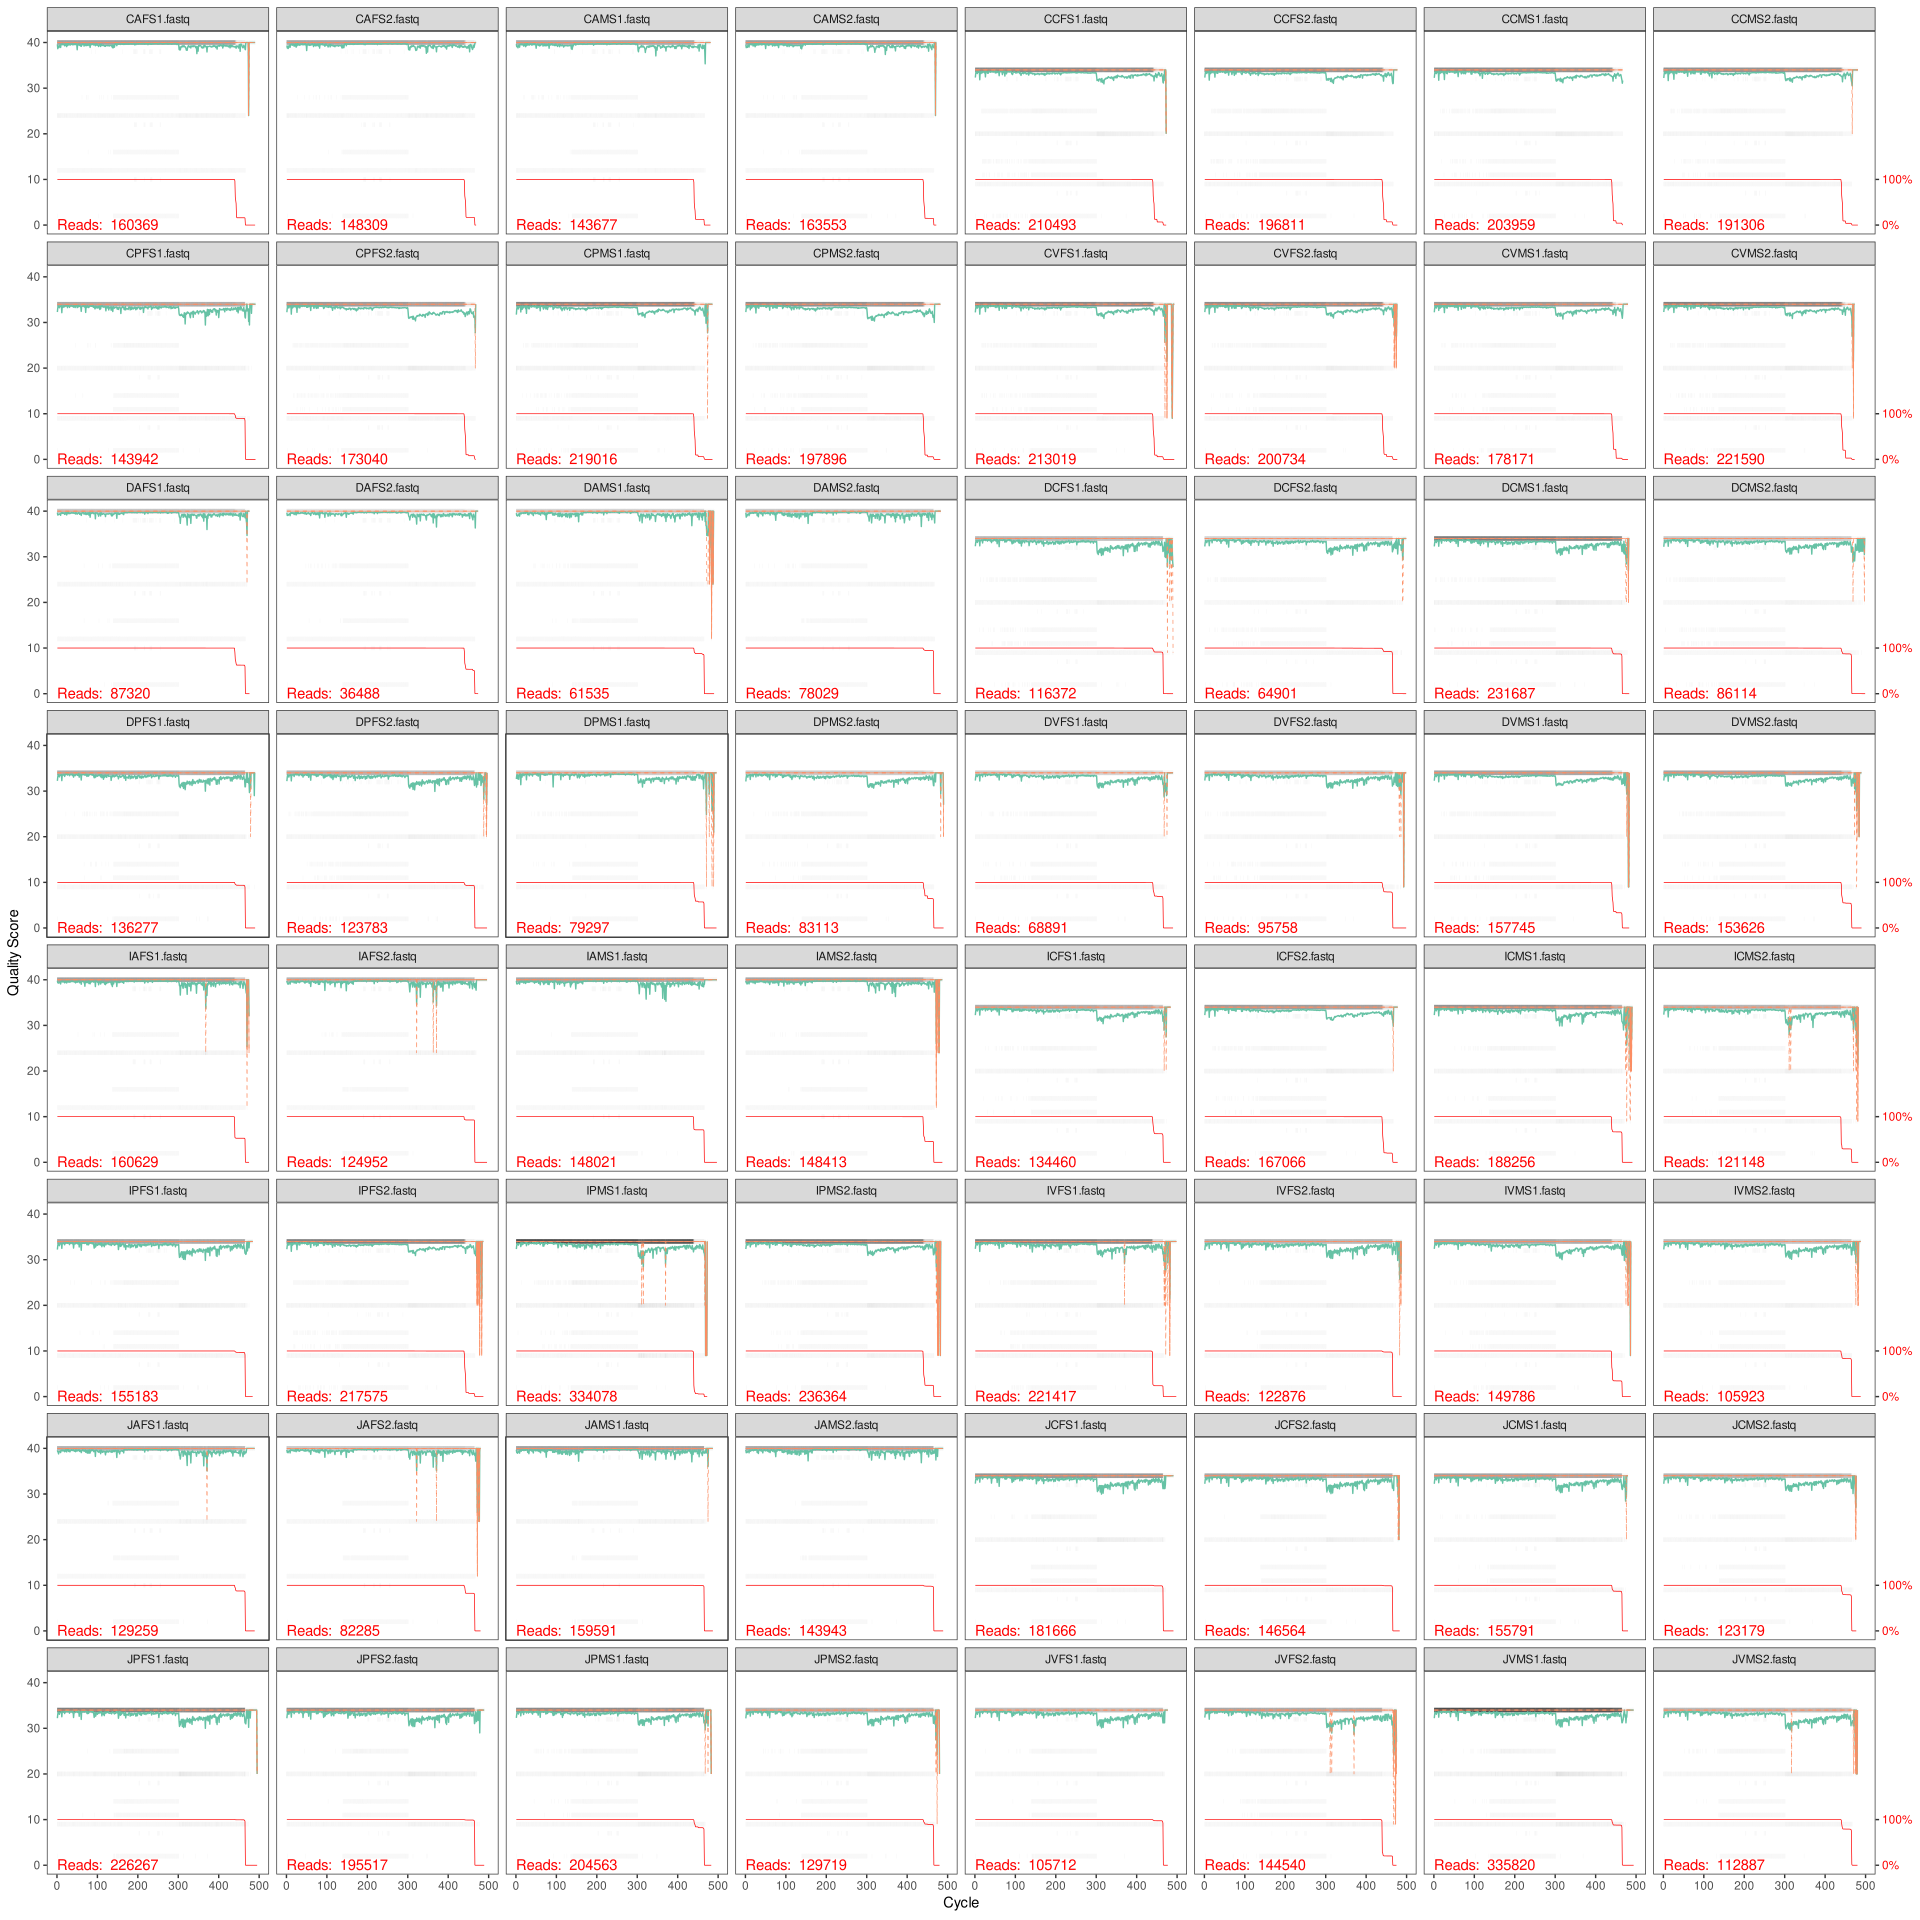
O resultado (Table 1) pode também ser visualizado na Figure 2 a seguir para apenas uma amostra IPMS2, como representante das demais. O download da imagem completa com todas as amostras pode ser feito pelos links seguintes às imagens.
| reads.in | reads.out | |
|---|---|---|
| CAFS1 | 160369 | 146379 |
| CAFS2 | 148309 | 135214 |
| CAMS1 | 143677 | 130684 |
| CAMS2 | 163553 | 149530 |
| CCFS1 | 210493 | 97455 |
| CCFS2 | 196811 | 93303 |
| CCMS1 | 203959 | 94431 |
| CCMS2 | 191306 | 90854 |
| CPFS1 | 143942 | 58840 |
| CPFS2 | 173040 | 65890 |
| CPMS1 | 219016 | 94349 |
| CPMS2 | 197896 | 75974 |
| CVFS1 | 213019 | 96841 |
| CVFS2 | 200734 | 93936 |
| CVMS1 | 178171 | 80328 |
| CVMS2 | 221590 | 103338 |
| DAFS1 | 87320 | 79153 |
| DAFS2 | 36488 | 33096 |
| DAMS1 | 61535 | 55277 |
| DAMS2 | 78029 | 70020 |
| DCFS1 | 116372 | 47241 |
| DCFS2 | 64901 | 27155 |
| DCMS1 | 231687 | 94731 |
| DCMS2 | 86114 | 36570 |
| DPFS1 | 136277 | 56128 |
| DPFS2 | 123783 | 49013 |
| DPMS1 | 79297 | 37513 |
| DPMS2 | 83113 | 33537 |
| DVFS1 | 68891 | 28605 |
| DVFS2 | 95758 | 40079 |
| DVMS1 | 157745 | 67964 |
| DVMS2 | 153626 | 67902 |
| IAFS1 | 160629 | 146036 |
| IAFS2 | 124952 | 113004 |
| IAMS1 | 148021 | 133117 |
| IAMS2 | 148413 | 134501 |
| ICFS1 | 134460 | 57166 |
| ICFS2 | 167066 | 70806 |
| ICMS1 | 188256 | 77861 |
| ICMS2 | 121148 | 47568 |
| IPFS1 | 155183 | 61065 |
| IPFS2 | 217575 | 100325 |
| IPMS1 | 334078 | 143887 |
| IPMS2 | 236364 | 107134 |
| IVFS1 | 221417 | 98311 |
| IVFS2 | 122876 | 50674 |
| IVMS1 | 149786 | 61633 |
| IVMS2 | 105923 | 44331 |
| JAFS1 | 129259 | 116256 |
| JAFS2 | 82285 | 74561 |
| JAMS1 | 159591 | 144021 |
| JAMS2 | 143943 | 129668 |
| JCFS1 | 181666 | 75031 |
| JCFS2 | 146564 | 60911 |
| JCMS1 | 155791 | 65917 |
| JCMS2 | 123179 | 52357 |
| JPFS1 | 226267 | 93776 |
| JPFS2 | 195517 | 82095 |
| JPMS1 | 204563 | 86907 |
| JPMS2 | 129719 | 54840 |
| JVFS1 | 105712 | 43614 |
| JVFS2 | 144540 | 53319 |
| JVMS1 | 335820 | 140997 |
| JVMS2 | 112887 | 39777 |

Quality Profile post DADA2 filtering and trimming (full image)

Identificação das taxas de erros
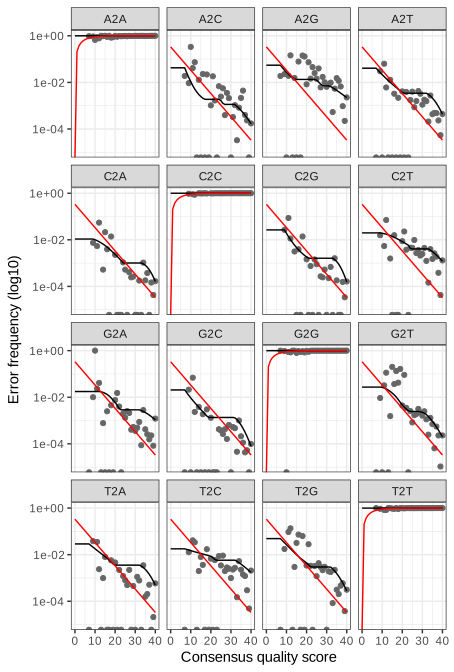
Os amplicons passaram então por um processo de identificação das taxas de erros a partir de um processo de aprendizado (learnErrors) que alterna entre estimativa de erros e inferência de um modelo para os erros apartir dos dados até atingir convergência. A representação gráfica do resultado deste processo pode ser observado na Figure 3. A sugestão proposta pelo autor do dada2 de forçar a monotonicidade do modelo de erros ajustado foi seguida. O número máximo de iterações na etapa de autoconsistência para estimar a taxa de erros foi incrementada para 25 (MAX_CONSIST = 25). A convergência foi atingida após 15 iterações.
Inferência das Amplicon Sequence Variants (ASVs)
As sequências de amplicons devidamente podadas e filtradas foram submetidas à deduplicação (dereplication) para em seguida o algoritmo do DADA2 inferir as Amplicon Sequence Variants (ASVs) seguindo um processo de remoção de ruídos (denoising) que leva em conta as taxas de erros identificadas na etapa anterior.
Identificação e filtragem de ASVs quiméricas
O resultado foi de 12267 ASVs. As quais foram submetidas à identificação de quimeras (removeBimeraDenovo) pelo método consensus (as sequências das amostras são analisadas independentemente e uma decisão é tomada por consenso para cada ASV), considerando um mínimo de 100 de abundância para as ASVs que podem ser consideradas candidatas a aparentadas (origem das quimeras) além de uma razão de abundância de no mínimo 10 em relação às potenciais quimeras.
Foram identificadas 676 ASVs quiméricas.
Números de leituras iniciais e abundâncias de ASVs
Abaixo (Table 2) os números de leituras iniciais e de abundâncias de ASVs após os processamentos até o momento.
| ID | Raw.reads | Cleaned.reads | FilteredAndTrimmed.reads | Denoised.asvs.abundance | ChimeraFree.asvs.abundance | NA | ContaminantFree.asvs.abundance | PercentUsable.reads |
|---|---|---|---|---|---|---|---|---|
| CAFS1 | 163941 | 162608 | 162271 | 146379 | 133521 | 132108 | 132108 | 80.58 |
| CAFS2 | 151444 | 150374 | 150082 | 135214 | 124592 | 123615 | 123615 | 81.62 |
| CAMS1 | 146978 | 145755 | 145456 | 130684 | 122103 | 121488 | 121488 | 82.66 |
| CAMS2 | 167274 | 165995 | 165647 | 149530 | 140362 | 139499 | 139499 | 83.40 |
| CCFS1 | 216687 | 216034 | 213223 | 97455 | 91862 | 91724 | 91724 | 42.33 |
| CCFS2 | 202999 | 202402 | 199844 | 93303 | 88492 | 88335 | 88335 | 43.51 |
| CCMS1 | 209990 | 209360 | 206593 | 94431 | 88442 | 88329 | 88329 | 42.06 |
| CCMS2 | 196923 | 196384 | 193837 | 90854 | 85451 | 85287 | 85287 | 43.31 |
| CPFS1 | 149702 | 149186 | 146721 | 58840 | 57491 | 57378 | 57213 | 38.22 |
| CPFS2 | 179192 | 178410 | 175469 | 65890 | 60765 | 60720 | 60720 | 33.89 |
| CPMS1 | 225944 | 225307 | 222025 | 94349 | 88462 | 88366 | 88366 | 39.11 |
| CPMS2 | 204777 | 203877 | 200417 | 75974 | 71746 | 71712 | 71712 | 35.02 |
| CVFS1 | 219402 | 218806 | 216016 | 96841 | 90552 | 90244 | 90244 | 41.13 |
| CVFS2 | 206738 | 206088 | 203338 | 93936 | 88020 | 87730 | 87730 | 42.44 |
| CVMS1 | 183364 | 182802 | 180303 | 80328 | 75603 | 75460 | 75460 | 41.15 |
| CVMS2 | 228355 | 227641 | 224443 | 103338 | 97726 | 97311 | 97311 | 42.61 |
| DAFS1 | 89919 | 89069 | 88855 | 79153 | 77685 | 77682 | 74986 | 83.39 |
| DAFS2 | 37520 | 37221 | 37128 | 33096 | 31415 | 31278 | 30107 | 80.24 |
| DAMS1 | 63626 | 63025 | 62852 | 55277 | 54113 | 54113 | 53928 | 84.76 |
| DAMS2 | 80819 | 79949 | 79754 | 70020 | 69255 | 69255 | 69077 | 85.47 |
| DCFS1 | 122736 | 122264 | 119958 | 47241 | 45948 | 45948 | 44652 | 36.38 |
| DCFS2 | 71285 | 71052 | 69459 | 27155 | 26210 | 26210 | 25582 | 35.89 |
| DCMS1 | 241679 | 240754 | 236533 | 94731 | 93269 | 93261 | 91663 | 37.93 |
| DCMS2 | 94201 | 93887 | 91956 | 36570 | 34520 | 34520 | 33886 | 35.97 |
| DPFS1 | 141958 | 141413 | 139058 | 56128 | 54566 | 54566 | 54430 | 38.34 |
| DPFS2 | 132107 | 131642 | 129113 | 49013 | 47680 | 47673 | 47589 | 36.02 |
| DPMS1 | 82003 | 81853 | 81303 | 37513 | 35099 | 35099 | 35095 | 42.80 |
| DPMS2 | 86790 | 86511 | 85030 | 33537 | 31655 | 31655 | 31655 | 36.47 |
| DVFS1 | 71960 | 71712 | 70502 | 28605 | 26832 | 26832 | 26483 | 36.80 |
| DVFS2 | 101484 | 101123 | 99234 | 40079 | 38316 | 38316 | 36797 | 36.26 |
| DVMS1 | 165859 | 165240 | 162414 | 67964 | 65906 | 65906 | 65088 | 39.24 |
| DVMS2 | 161059 | 160495 | 157774 | 67902 | 65670 | 65670 | 64415 | 39.99 |
| IAFS1 | 164482 | 162981 | 162598 | 146036 | 145187 | 145040 | 144867 | 88.07 |
| IAFS2 | 127785 | 126693 | 126453 | 113004 | 112451 | 112403 | 112068 | 87.70 |
| IAMS1 | 151730 | 150339 | 150022 | 133117 | 132575 | 132530 | 132530 | 87.35 |
| IAMS2 | 151673 | 150412 | 150134 | 134501 | 131718 | 131489 | 131440 | 86.66 |
| ICFS1 | 139909 | 139294 | 137047 | 57166 | 55466 | 55466 | 53919 | 38.54 |
| ICFS2 | 172816 | 172200 | 169766 | 70806 | 68126 | 68119 | 67763 | 39.21 |
| ICMS1 | 194877 | 194122 | 190916 | 77861 | 76915 | 76866 | 76830 | 39.42 |
| ICMS2 | 125665 | 125217 | 123052 | 47568 | 46412 | 46412 | 46412 | 36.93 |
| IPFS1 | 160962 | 160350 | 157707 | 61065 | 60239 | 60166 | 60116 | 37.35 |
| IPFS2 | 224428 | 223737 | 220523 | 100325 | 94051 | 93664 | 93664 | 41.73 |
| IPMS1 | 345759 | 344508 | 338773 | 143887 | 141391 | 141391 | 140958 | 40.77 |
| IPMS2 | 244089 | 243196 | 239379 | 107134 | 104116 | 104083 | 104083 | 42.64 |
| IVFS1 | 228943 | 228051 | 224175 | 98311 | 97214 | 96796 | 96792 | 42.28 |
| IVFS2 | 127420 | 126977 | 124970 | 50674 | 50127 | 50127 | 49995 | 39.24 |
| IVMS1 | 156119 | 155447 | 152375 | 61633 | 59851 | 59787 | 59092 | 37.85 |
| IVMS2 | 109737 | 109319 | 107543 | 44331 | 43464 | 43464 | 43141 | 39.31 |
| JAFS1 | 132370 | 131141 | 130880 | 116256 | 115232 | 115139 | 113279 | 85.58 |
| JAFS2 | 84149 | 83508 | 83364 | 74561 | 73626 | 73619 | 69237 | 82.28 |
| JAMS1 | 163443 | 161997 | 161702 | 144021 | 143593 | 143576 | 143532 | 87.82 |
| JAMS2 | 147745 | 146335 | 146024 | 129668 | 126979 | 126963 | 126893 | 85.89 |
| JCFS1 | 188244 | 187605 | 184694 | 75031 | 74607 | 74573 | 74307 | 39.47 |
| JCFS2 | 152204 | 151667 | 149196 | 60911 | 60614 | 60614 | 60460 | 39.72 |
| JCMS1 | 161387 | 160867 | 158300 | 65917 | 64271 | 64271 | 64131 | 39.74 |
| JCMS2 | 127452 | 127003 | 125095 | 52357 | 50524 | 50524 | 49615 | 38.93 |
| JPFS1 | 233623 | 232873 | 229459 | 93776 | 93423 | 93423 | 93423 | 39.99 |
| JPFS2 | 201772 | 201164 | 198133 | 82095 | 81554 | 81554 | 81532 | 40.41 |
| JPMS1 | 211303 | 210585 | 207376 | 86907 | 85378 | 85279 | 85228 | 40.33 |
| JPMS2 | 134191 | 133793 | 131720 | 54840 | 53465 | 53465 | 53399 | 39.79 |
| JVFS1 | 109795 | 109392 | 107567 | 43614 | 42973 | 42973 | 42811 | 38.99 |
| JVFS2 | 150055 | 149301 | 146425 | 53319 | 52239 | 52095 | 52095 | 34.72 |
| JVMS1 | 347311 | 346075 | 340804 | 140997 | 138902 | 138902 | 135201 | 38.93 |
| JVMS2 | 117324 | 116755 | 114501 | 39777 | 37933 | 37896 | 36913 | 31.46 |
Tabela de contagem ASVs
O número total de ASVs válidas é de 11591. As sequências fasta das ASVs podem ser acessadas no link abaixo.
Atribuição taxonômica às ASVs
Para a atribuição taxonômica, as funções assignTaxonomy() e addSpecies(), ambas do pacote DADA2 foram utilizadas com base nos bancos de dados GTDB (GTDB_bac120_arc122_ssu_r202), RDP (rdp_train_set_18), RefRDP (RefSeq_16S_6-11-20_RDPv16), e SILVA (silva_nr99_v138.1_train_set). As possibilidades de correspondências foram consideradas em ambas as orientações e com um mínimo de valor de bootstrap de 60%.
Identificação e filtragem de ASVs contaminantes
Além disso foram feitas filtragens de ASVs contaminantes ou não classificadas (Padrões buscados: “Chloroplast;”,“Mitochondria;”,“^Unclassified;”,“^Eukaryota;”) resultando em 11474 ASVs válidas livres de contaminantes.
As sequências fasta livre de contaminantes podem ser acessadas no link abaixo.
Resultados das atribuições taxonômicas
As Table 3 e Table 4 sumarizam o resultado das atribuições taxonômicas correspondentes aos diferentes bancos de dados considerados no processo.
| Database | Kingdom | Phylum | Class | Order | Family | Genus | Species | |
|---|---|---|---|---|---|---|---|---|
| 2 | GTDB | 11465 | 10889 | 10605 | 10134 | 9649 | 6014 | 10 |
| 3 | RDP | 11458 | 11082 | 10370 | 10264 | 8270 | 3490 | 11474 |
| 4 | RefRDP | 11458 | 10841 | 10065 | 9929 | 7248 | 3536 | 2 |
| 5 | Silva | 11469 | 11325 | 11220 | 10604 | 8246 | 4415 | 11474 |
| Database | UnqKingdom | UnqPhylum | UnqClass | UnqOrder | UnqFamily | UnqGenus | UnqSpecies | |
|---|---|---|---|---|---|---|---|---|
| 2 | GTDB | 1 | 25 | 45 | 97 | 161 | 289 | 10 |
| 3 | RDP | 1 | 16 | 38 | 69 | 113 | 165 | 3 |
| 4 | RefRDP | 1 | 15 | 32 | 62 | 103 | 154 | 2 |
| 5 | Silva | 1 | 19 | 43 | 91 | 133 | 198 | 5 |
Planilha das ASVs com atribuição taxonômica
Por fim, selecionamos as atribuições taxonômicas realizadas com o banco de dados RDP, afinal é um banco de dados que possui curadoria, e portanto, confiabilidade. Além disson, possui uma quantidade satisfatória de ASVs reconhecidas até o nível de gênero.
A planilha contendo os resultados da atribuição taxonômica com o banco de dados RDP pode ser acessada no link abaixo. Além das atribuições taxonômicas ao longo dos níveis, a planilha contém a soma da abundância e o número que representa a prevalência das ASVs entre as amostras.
No geral, houve 89.89% de dados com identificação da família, 73.54% de dados com informação de gênero, e 0.01% de dados com informação de espécie.
A tabela anterior (Table 2) com os números de leituras portanto foi atualizada (Table 5) com novas colunas.
| ID | Raw.reads | Cleaned.reads | FilteredAndTrimmed.reads | Denoised.asvs.abundance | ChimeraFree.asvs.abundance | NA | ContaminantFree.asvs.abundance | PercentUsable.reads |
|---|---|---|---|---|---|---|---|---|
| CAFS1 | 163941 | 162608 | 162271 | 146379 | 133521 | 132108 | 132108 | 80.58 |
| CAFS2 | 151444 | 150374 | 150082 | 135214 | 124592 | 123615 | 123615 | 81.62 |
| CAMS1 | 146978 | 145755 | 145456 | 130684 | 122103 | 121488 | 121488 | 82.66 |
| CAMS2 | 167274 | 165995 | 165647 | 149530 | 140362 | 139499 | 139499 | 83.40 |
| CCFS1 | 216687 | 216034 | 213223 | 97455 | 91862 | 91724 | 91724 | 42.33 |
| CCFS2 | 202999 | 202402 | 199844 | 93303 | 88492 | 88335 | 88335 | 43.51 |
| CCMS1 | 209990 | 209360 | 206593 | 94431 | 88442 | 88329 | 88329 | 42.06 |
| CCMS2 | 196923 | 196384 | 193837 | 90854 | 85451 | 85287 | 85287 | 43.31 |
| CPFS1 | 149702 | 149186 | 146721 | 58840 | 57491 | 57378 | 57213 | 38.22 |
| CPFS2 | 179192 | 178410 | 175469 | 65890 | 60765 | 60720 | 60720 | 33.89 |
| CPMS1 | 225944 | 225307 | 222025 | 94349 | 88462 | 88366 | 88366 | 39.11 |
| CPMS2 | 204777 | 203877 | 200417 | 75974 | 71746 | 71712 | 71712 | 35.02 |
| CVFS1 | 219402 | 218806 | 216016 | 96841 | 90552 | 90244 | 90244 | 41.13 |
| CVFS2 | 206738 | 206088 | 203338 | 93936 | 88020 | 87730 | 87730 | 42.44 |
| CVMS1 | 183364 | 182802 | 180303 | 80328 | 75603 | 75460 | 75460 | 41.15 |
| CVMS2 | 228355 | 227641 | 224443 | 103338 | 97726 | 97311 | 97311 | 42.61 |
| DAFS1 | 89919 | 89069 | 88855 | 79153 | 77685 | 77682 | 74986 | 83.39 |
| DAFS2 | 37520 | 37221 | 37128 | 33096 | 31415 | 31278 | 30107 | 80.24 |
| DAMS1 | 63626 | 63025 | 62852 | 55277 | 54113 | 54113 | 53928 | 84.76 |
| DAMS2 | 80819 | 79949 | 79754 | 70020 | 69255 | 69255 | 69077 | 85.47 |
| DCFS1 | 122736 | 122264 | 119958 | 47241 | 45948 | 45948 | 44652 | 36.38 |
| DCFS2 | 71285 | 71052 | 69459 | 27155 | 26210 | 26210 | 25582 | 35.89 |
| DCMS1 | 241679 | 240754 | 236533 | 94731 | 93269 | 93261 | 91663 | 37.93 |
| DCMS2 | 94201 | 93887 | 91956 | 36570 | 34520 | 34520 | 33886 | 35.97 |
| DPFS1 | 141958 | 141413 | 139058 | 56128 | 54566 | 54566 | 54430 | 38.34 |
| DPFS2 | 132107 | 131642 | 129113 | 49013 | 47680 | 47673 | 47589 | 36.02 |
| DPMS1 | 82003 | 81853 | 81303 | 37513 | 35099 | 35099 | 35095 | 42.80 |
| DPMS2 | 86790 | 86511 | 85030 | 33537 | 31655 | 31655 | 31655 | 36.47 |
| DVFS1 | 71960 | 71712 | 70502 | 28605 | 26832 | 26832 | 26483 | 36.80 |
| DVFS2 | 101484 | 101123 | 99234 | 40079 | 38316 | 38316 | 36797 | 36.26 |
| DVMS1 | 165859 | 165240 | 162414 | 67964 | 65906 | 65906 | 65088 | 39.24 |
| DVMS2 | 161059 | 160495 | 157774 | 67902 | 65670 | 65670 | 64415 | 39.99 |
| IAFS1 | 164482 | 162981 | 162598 | 146036 | 145187 | 145040 | 144867 | 88.07 |
| IAFS2 | 127785 | 126693 | 126453 | 113004 | 112451 | 112403 | 112068 | 87.70 |
| IAMS1 | 151730 | 150339 | 150022 | 133117 | 132575 | 132530 | 132530 | 87.35 |
| IAMS2 | 151673 | 150412 | 150134 | 134501 | 131718 | 131489 | 131440 | 86.66 |
| ICFS1 | 139909 | 139294 | 137047 | 57166 | 55466 | 55466 | 53919 | 38.54 |
| ICFS2 | 172816 | 172200 | 169766 | 70806 | 68126 | 68119 | 67763 | 39.21 |
| ICMS1 | 194877 | 194122 | 190916 | 77861 | 76915 | 76866 | 76830 | 39.42 |
| ICMS2 | 125665 | 125217 | 123052 | 47568 | 46412 | 46412 | 46412 | 36.93 |
| IPFS1 | 160962 | 160350 | 157707 | 61065 | 60239 | 60166 | 60116 | 37.35 |
| IPFS2 | 224428 | 223737 | 220523 | 100325 | 94051 | 93664 | 93664 | 41.73 |
| IPMS1 | 345759 | 344508 | 338773 | 143887 | 141391 | 141391 | 140958 | 40.77 |
| IPMS2 | 244089 | 243196 | 239379 | 107134 | 104116 | 104083 | 104083 | 42.64 |
| IVFS1 | 228943 | 228051 | 224175 | 98311 | 97214 | 96796 | 96792 | 42.28 |
| IVFS2 | 127420 | 126977 | 124970 | 50674 | 50127 | 50127 | 49995 | 39.24 |
| IVMS1 | 156119 | 155447 | 152375 | 61633 | 59851 | 59787 | 59092 | 37.85 |
| IVMS2 | 109737 | 109319 | 107543 | 44331 | 43464 | 43464 | 43141 | 39.31 |
| JAFS1 | 132370 | 131141 | 130880 | 116256 | 115232 | 115139 | 113279 | 85.58 |
| JAFS2 | 84149 | 83508 | 83364 | 74561 | 73626 | 73619 | 69237 | 82.28 |
| JAMS1 | 163443 | 161997 | 161702 | 144021 | 143593 | 143576 | 143532 | 87.82 |
| JAMS2 | 147745 | 146335 | 146024 | 129668 | 126979 | 126963 | 126893 | 85.89 |
| JCFS1 | 188244 | 187605 | 184694 | 75031 | 74607 | 74573 | 74307 | 39.47 |
| JCFS2 | 152204 | 151667 | 149196 | 60911 | 60614 | 60614 | 60460 | 39.72 |
| JCMS1 | 161387 | 160867 | 158300 | 65917 | 64271 | 64271 | 64131 | 39.74 |
| JCMS2 | 127452 | 127003 | 125095 | 52357 | 50524 | 50524 | 49615 | 38.93 |
| JPFS1 | 233623 | 232873 | 229459 | 93776 | 93423 | 93423 | 93423 | 39.99 |
| JPFS2 | 201772 | 201164 | 198133 | 82095 | 81554 | 81554 | 81532 | 40.41 |
| JPMS1 | 211303 | 210585 | 207376 | 86907 | 85378 | 85279 | 85228 | 40.33 |
| JPMS2 | 134191 | 133793 | 131720 | 54840 | 53465 | 53465 | 53399 | 39.79 |
| JVFS1 | 109795 | 109392 | 107567 | 43614 | 42973 | 42973 | 42811 | 38.99 |
| JVFS2 | 150055 | 149301 | 146425 | 53319 | 52239 | 52095 | 52095 | 34.72 |
| JVMS1 | 347311 | 346075 | 340804 | 140997 | 138902 | 138902 | 135201 | 38.93 |
| JVMS2 | 117324 | 116755 | 114501 | 39777 | 37933 | 37896 | 36913 | 31.46 |
Análise Filogenética
As 11474 livres de contaminantes foram alinhadas com pacote DECIPHER e usando pacote phangorn foi estimada uma árvore filogenética de Máxima Verossimilhança com a função pml() , a partir de uma árvore Neighbor-Joining utilizando parâmetros pré-definidos (default). Essa árvore inicial foi otimizada com a função optimim.pml() considerando rearranjos nos ramos por NNI (Nearest Neighbor Interchange), o modelo evolutivo General Time Reversible (GTR), e a otimização de parâmetros do modelo, tais como a proporção de sítios invariáveis (a partir do valor 0,2) e o parâmetro gamma. Em resumo, a análise filogenética segue a sugestão de (Callahan et al. 2016) exceto pelo método de rearranjo dos ramos.
Arquivos para exploração com MicrobiomeAnalyst
Os arquivos a seguir servem para análises em plataformas externas como o MicrobiomeAnalyst. Essa plataforma exige que os dados estejam em replicatas (NO MÍNIMO 3 RÉPLICAS), dessa forma, cada amostra será replicada 3 vezes por um procedimento de subamostragem com repetição. O procedimento de subamostragem foi realizado com a função rarefy_even_depth() do pacote phyloseq v1.38.0 do R.
Análises ecológicas
Utilizamos os pacotes phyloseq v1.38.0 e vegan v2.6-4 no R para as análises subsequentes. A seguir temos um resultado do quanto a matriz de ASVs é esparsa 1 usando a função summarize_phyloseq() que sumariza os resultados do objeto phyloseq sem a rarefação (Sparsity = 0.971296518215095).
Rarefação dos dados
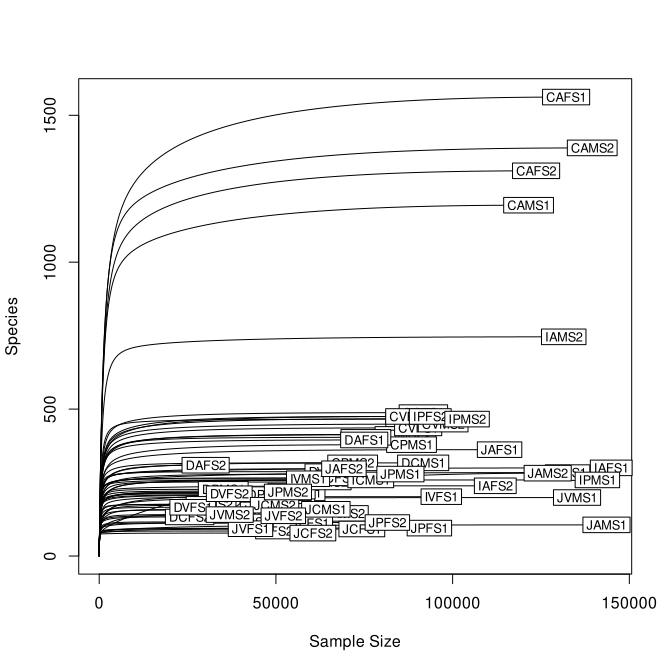
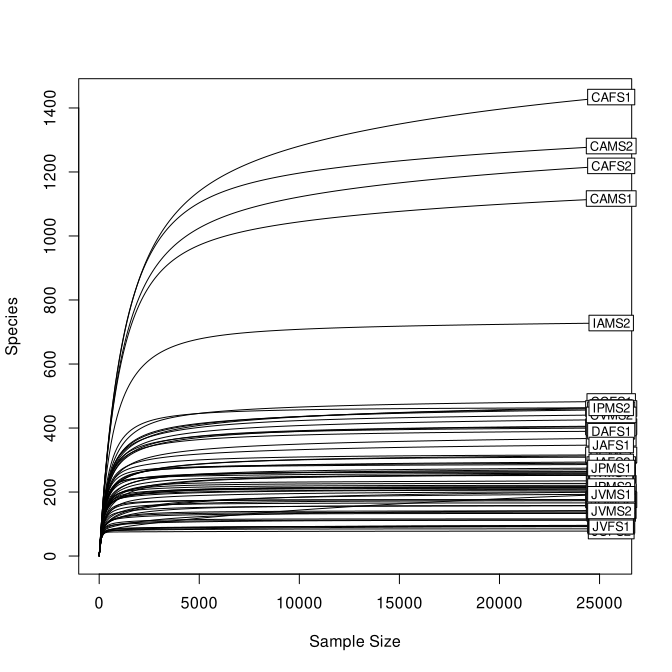
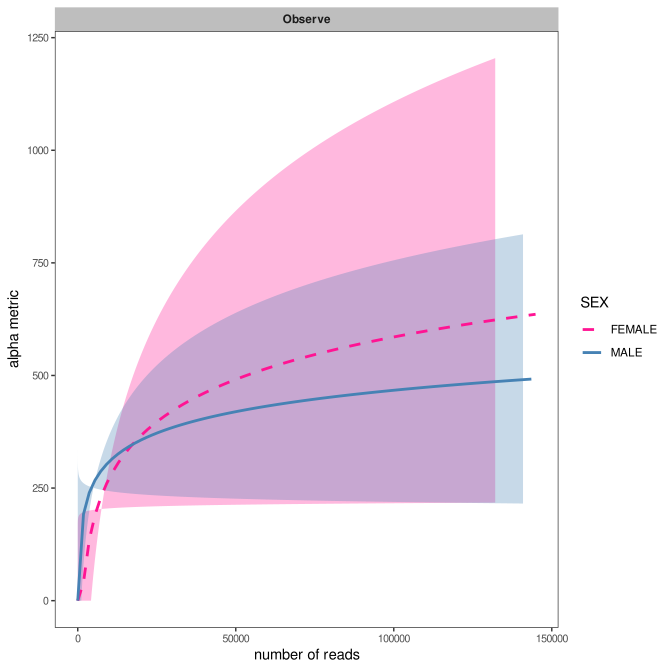
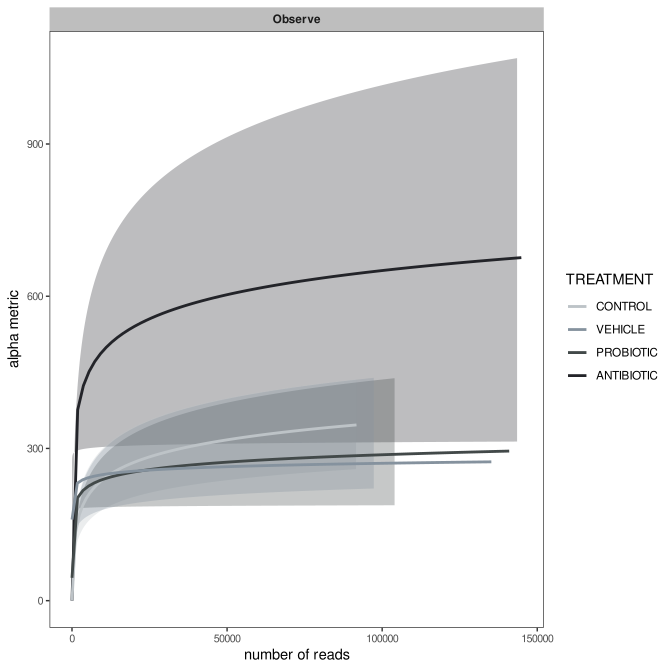
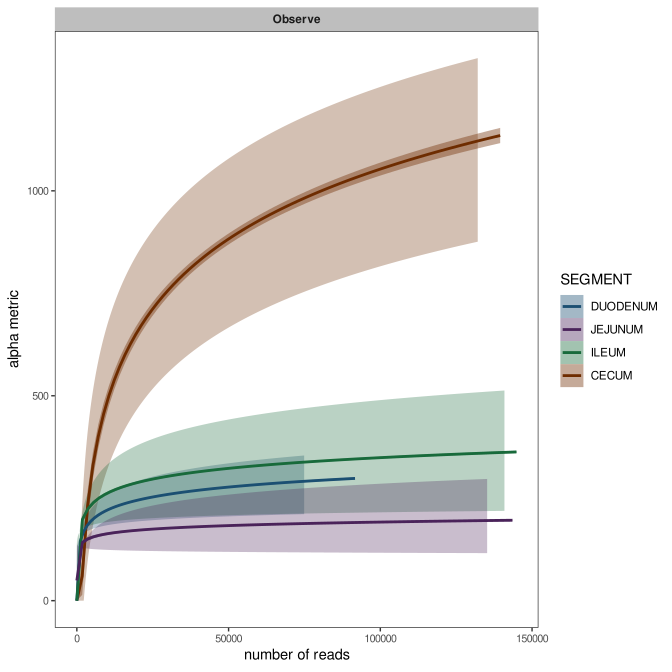
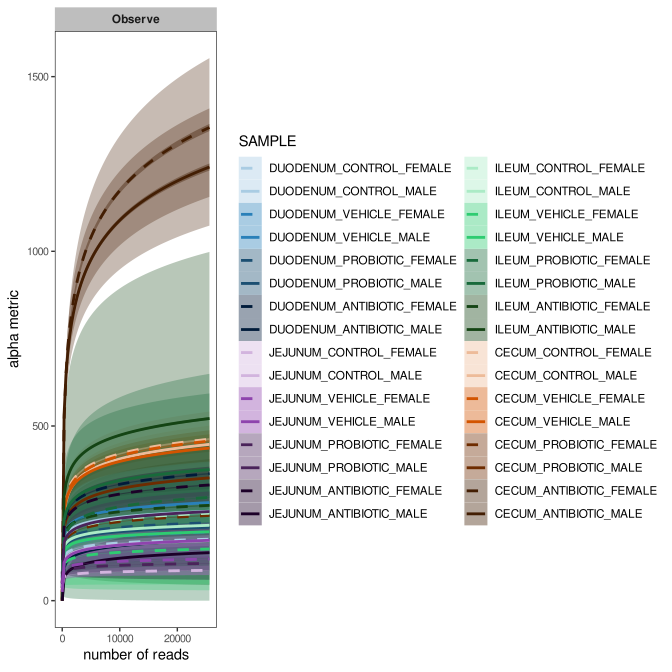
Nessas análises consideramos os dados após a rarefação em relação ao 25º percentil da distribuição de tamanho das amostras (53073) (Figure 4). A rarefação foi feita para as amostras com um número de contagens maiores que o valor definido para a rarefação. As amostras menores que o valor definido foram apenas acrescentadas. Por fim, as ASVs que após a rarefação ficaram zeradas (234) foram removidas. Também podem ser consultados mais detalhes na análise de rarefação por grupos de amostras (Figure 5). As figuras foram geradas a partir da suavização dos valores de contagem de reads e respectivos intervalos de confiança (95%) quando apresentados.
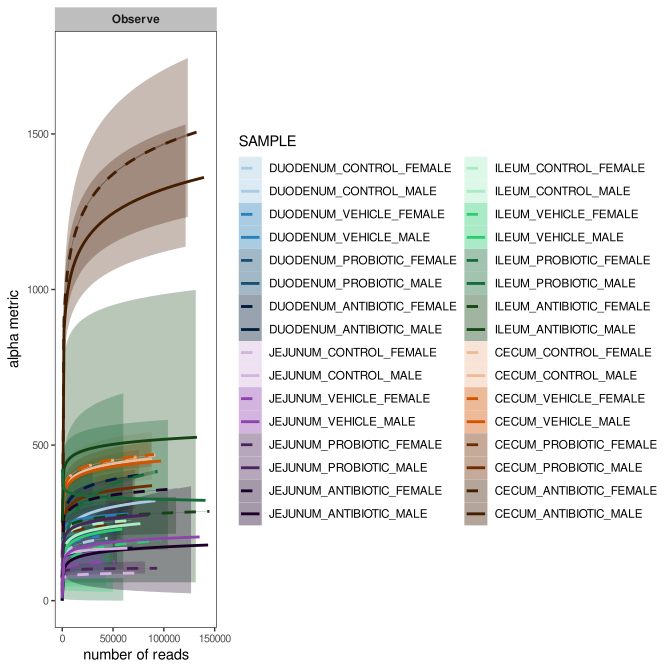
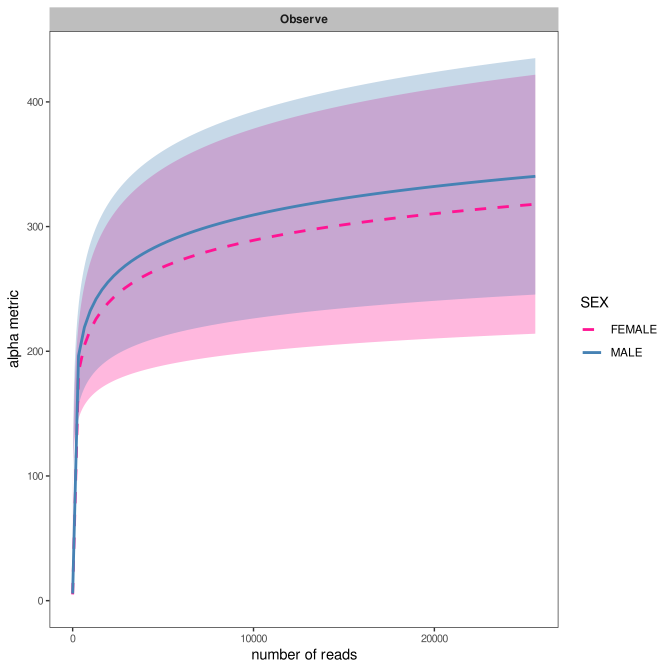
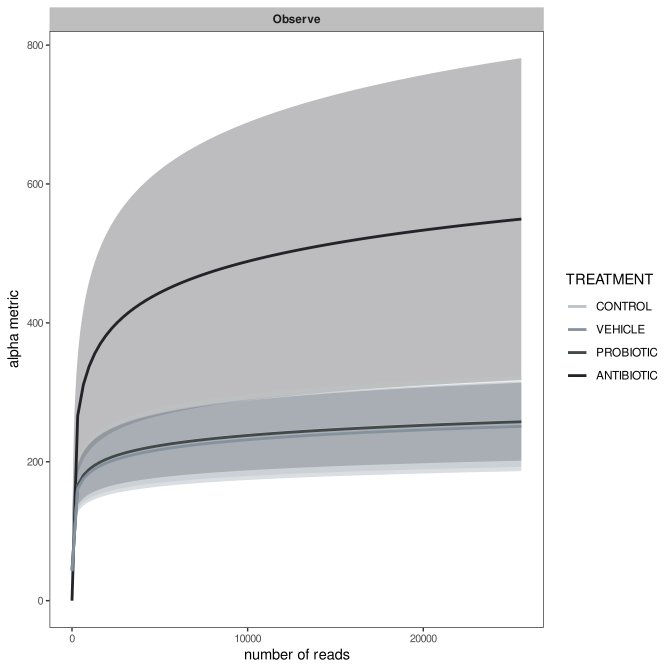
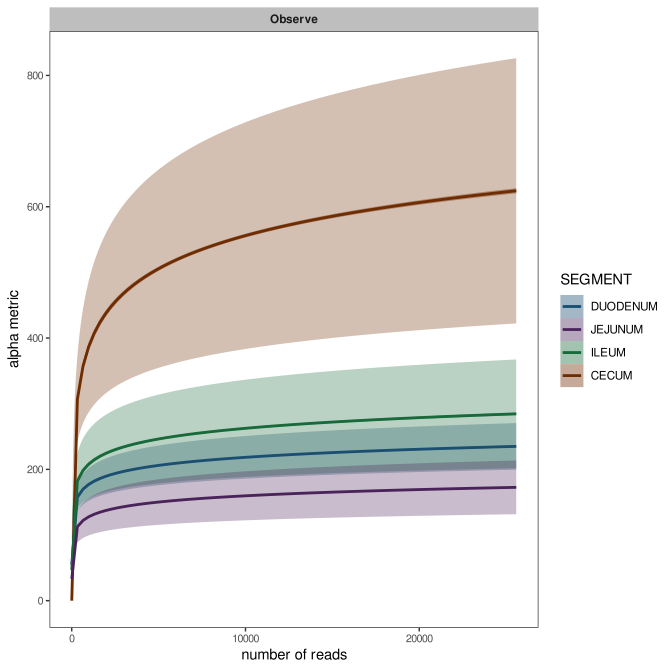
A seguir temos um resultado do quanto a matriz de ASVs após a rarefação é esparsa utilizando a função summarize_phyloseq() que sumariza os resultados do objeto phyloseq, desta vez após a rarefação (Sparsity = 0.970458236658933).
Shared OTUs
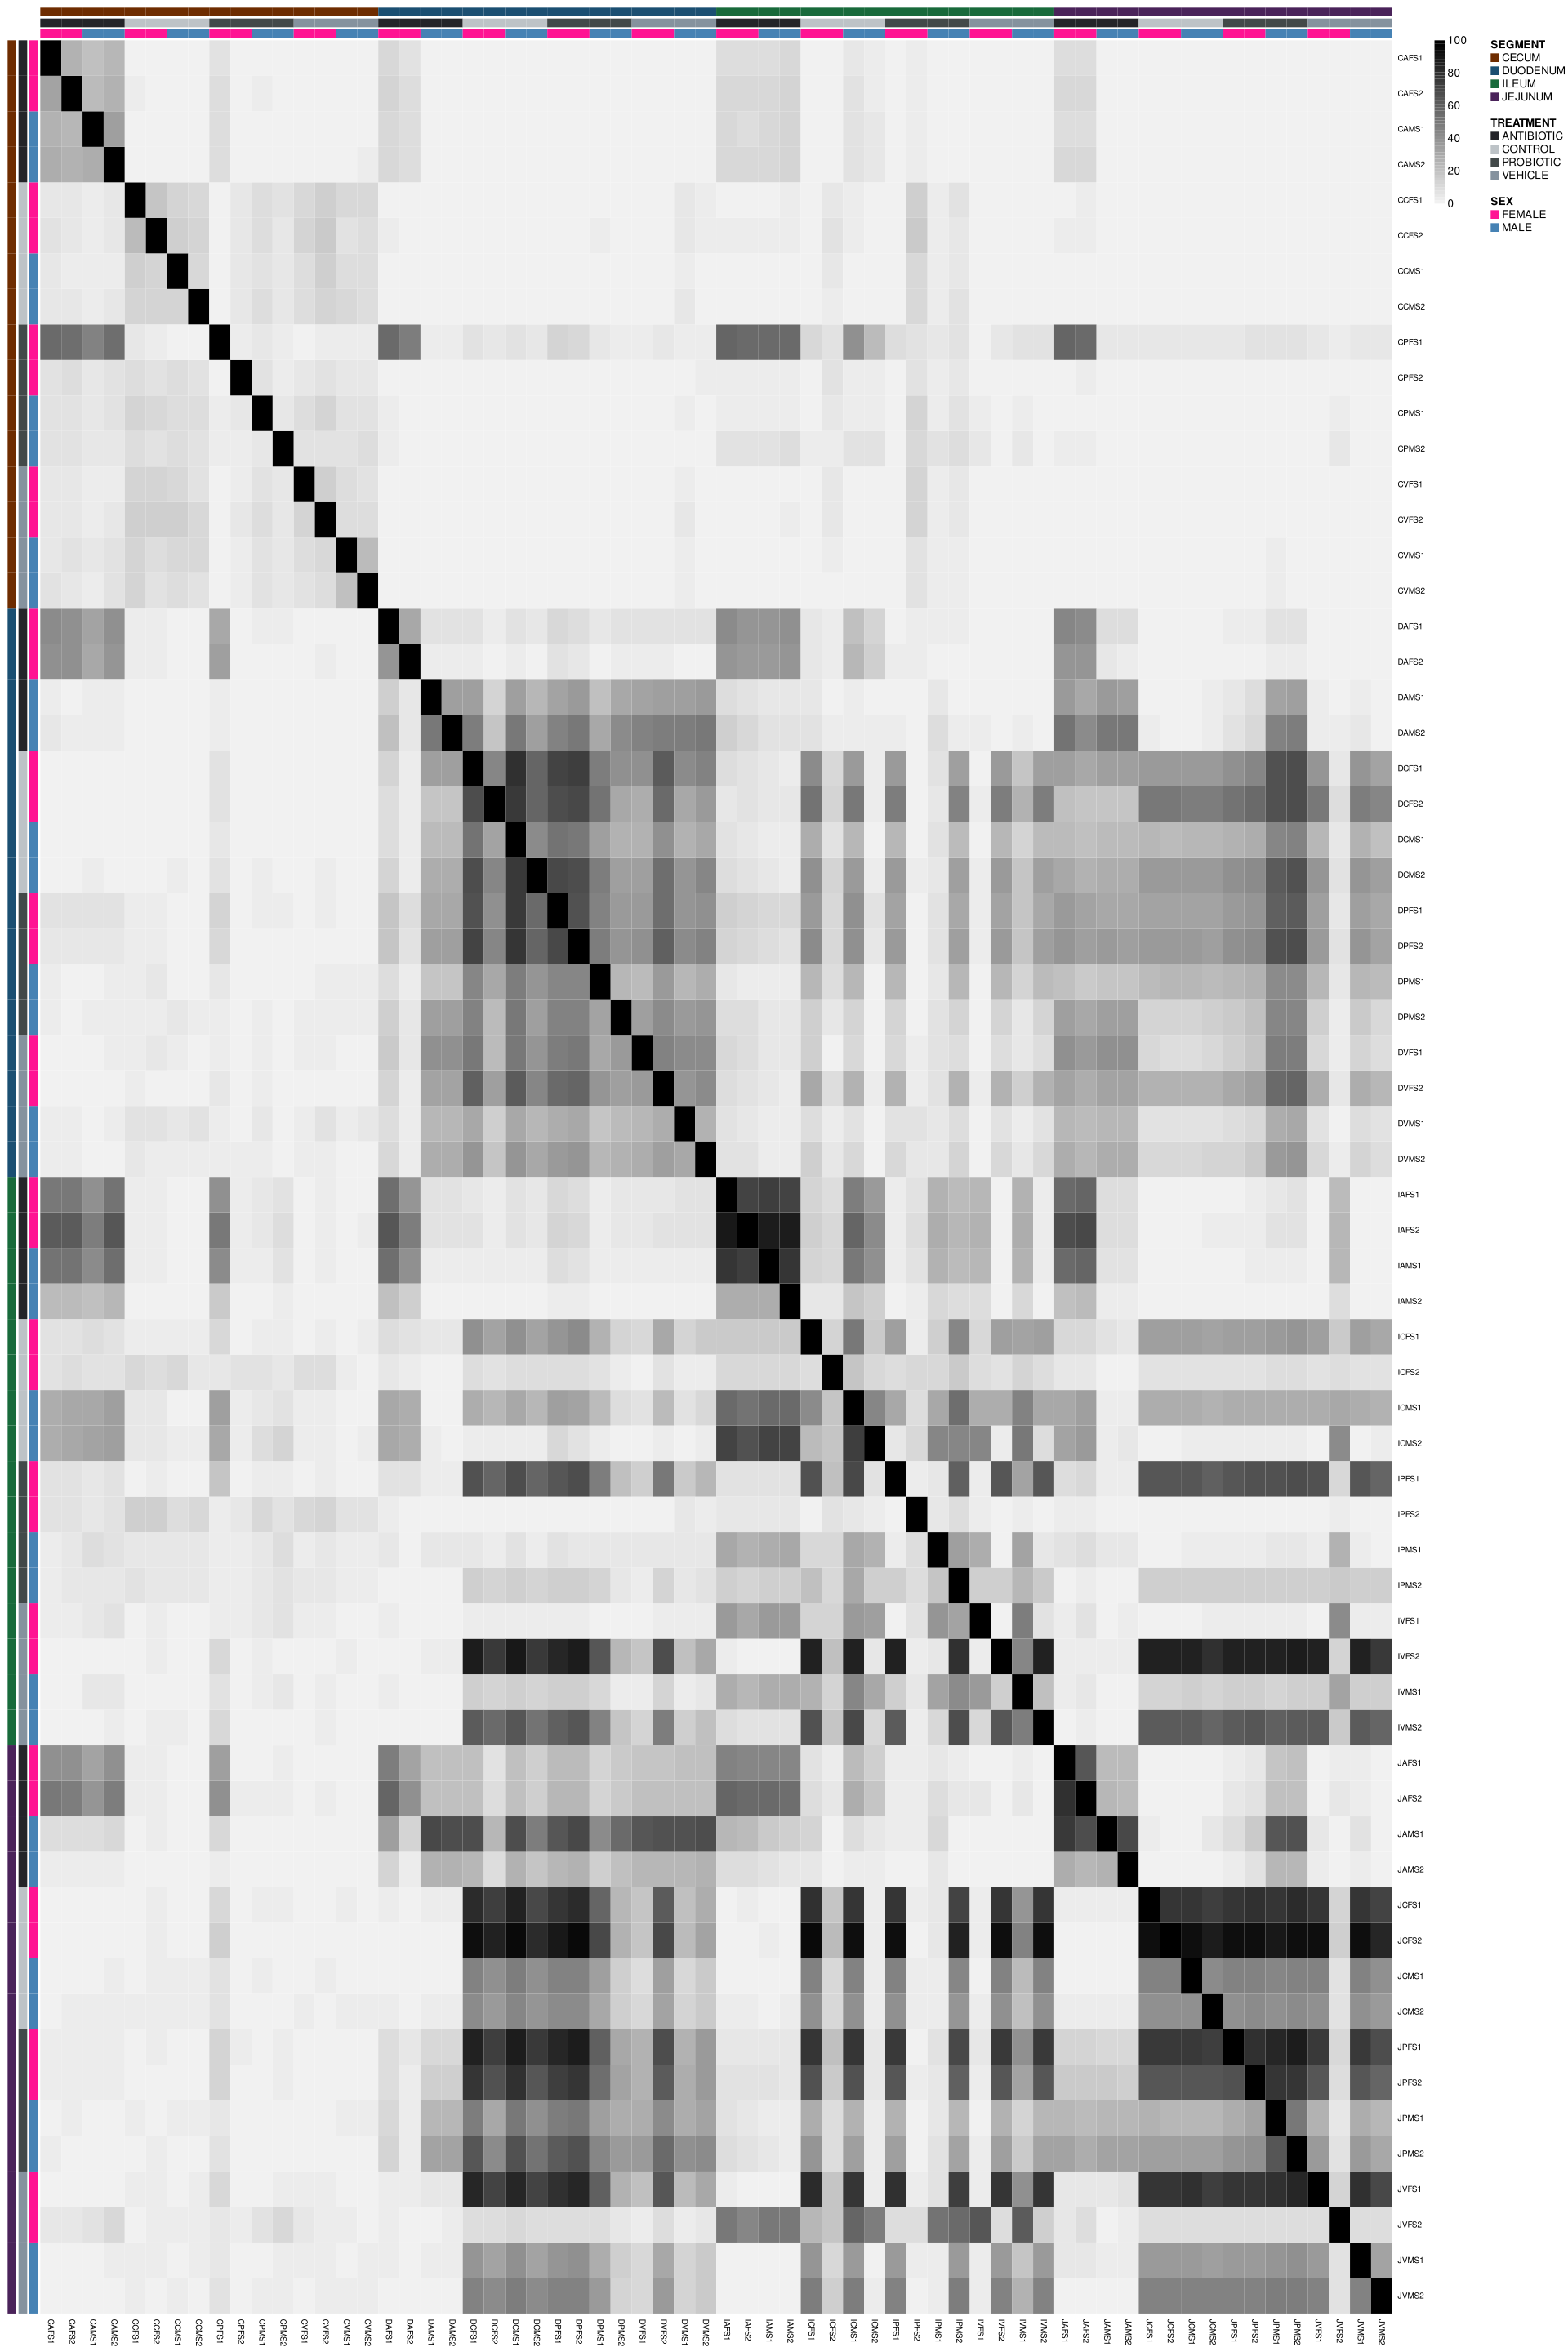
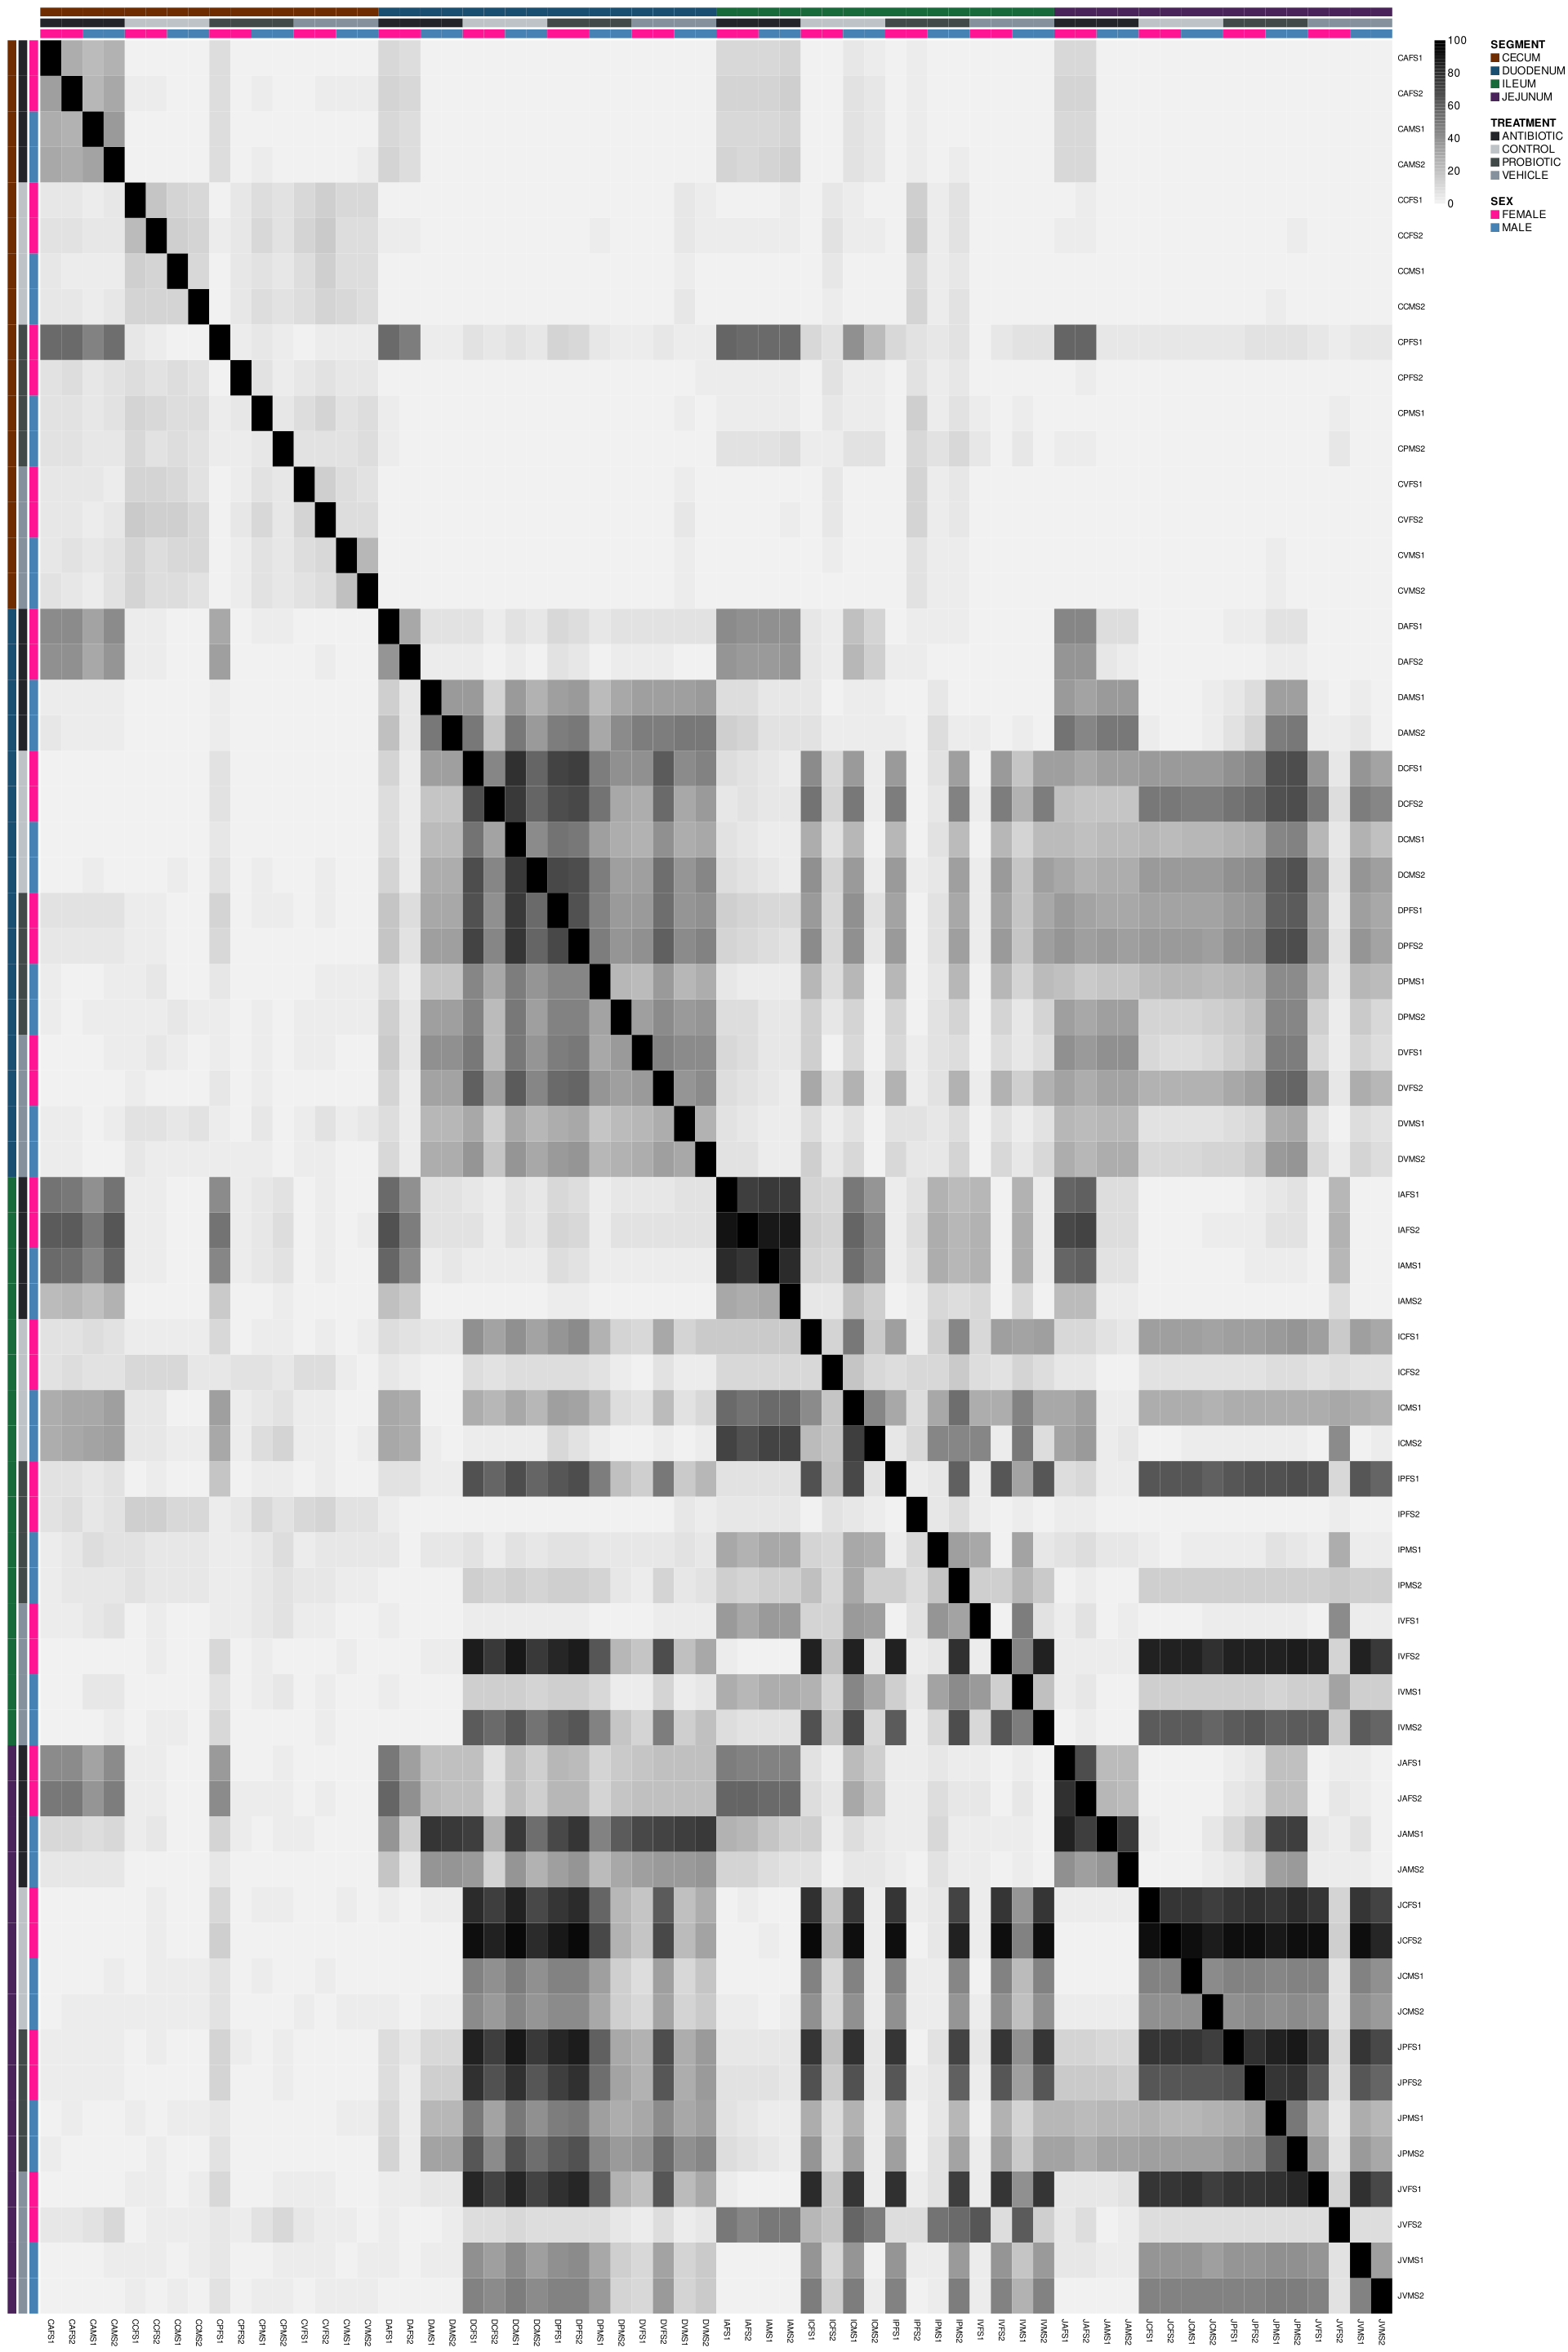
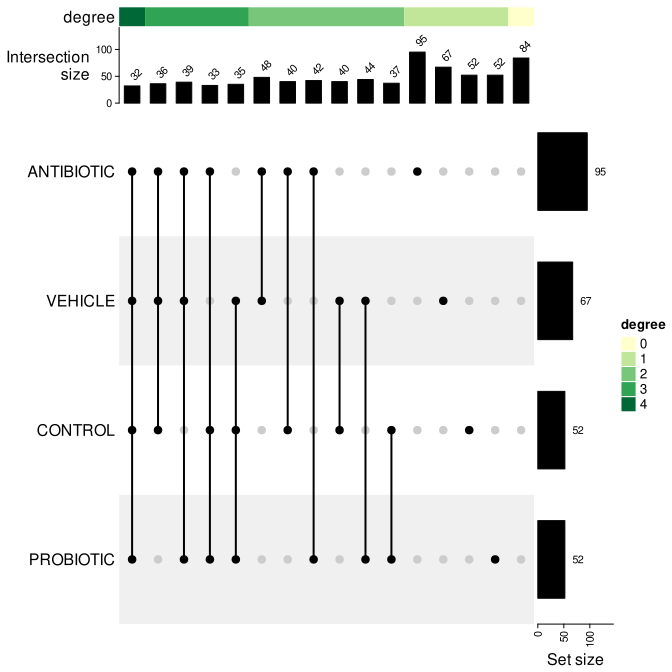
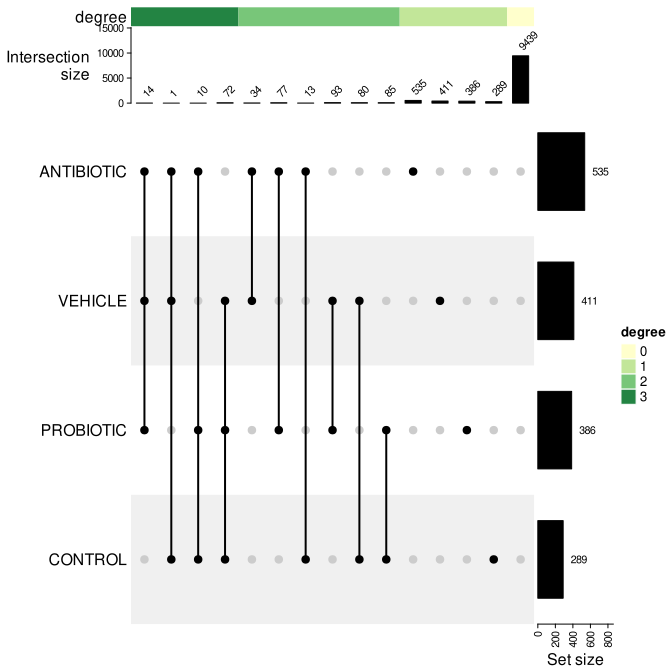
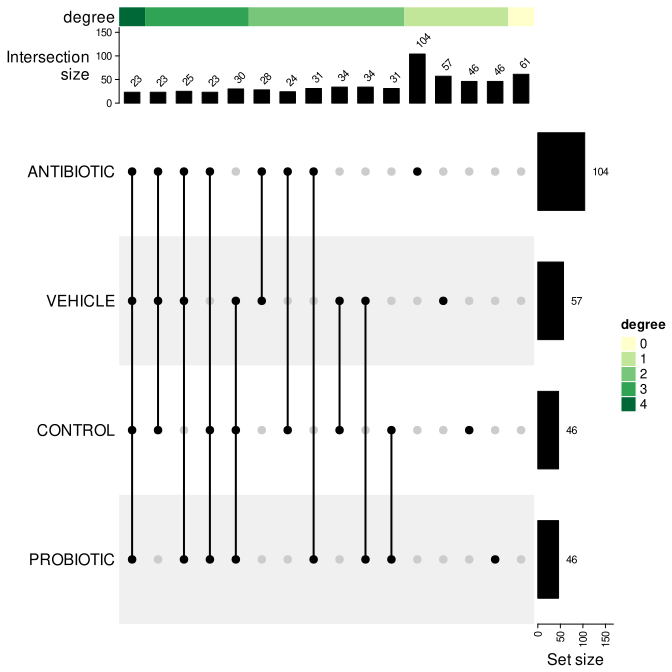
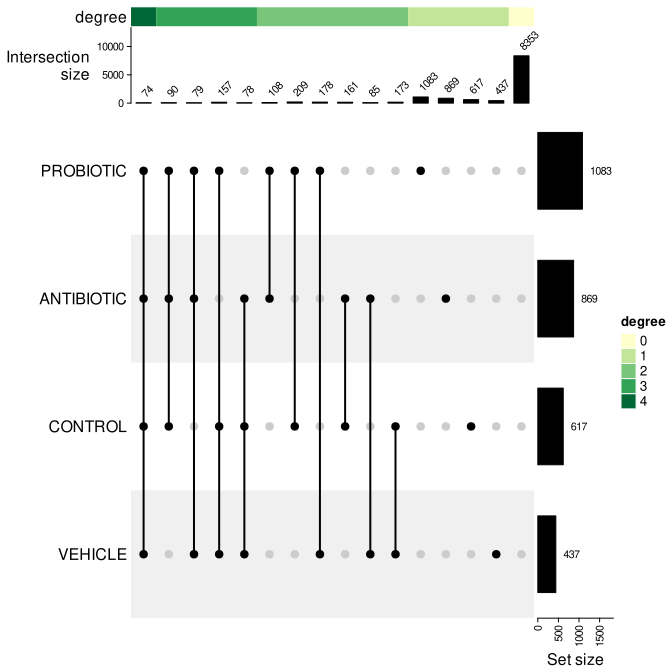
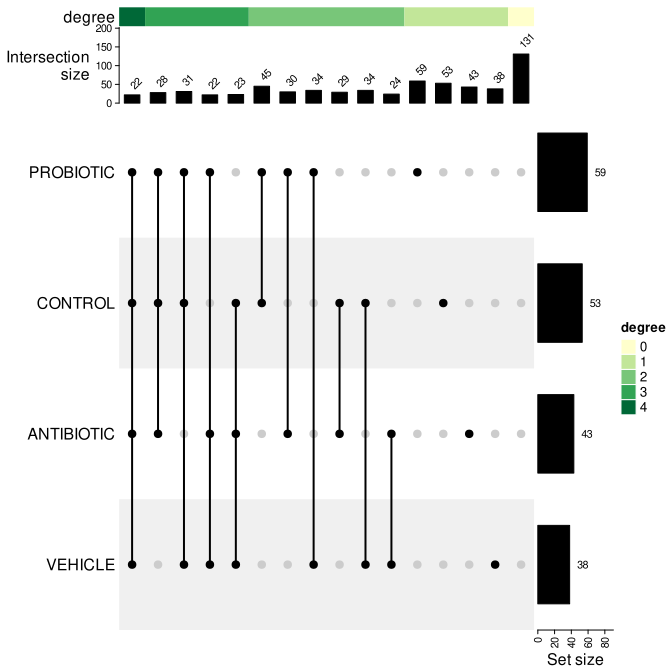
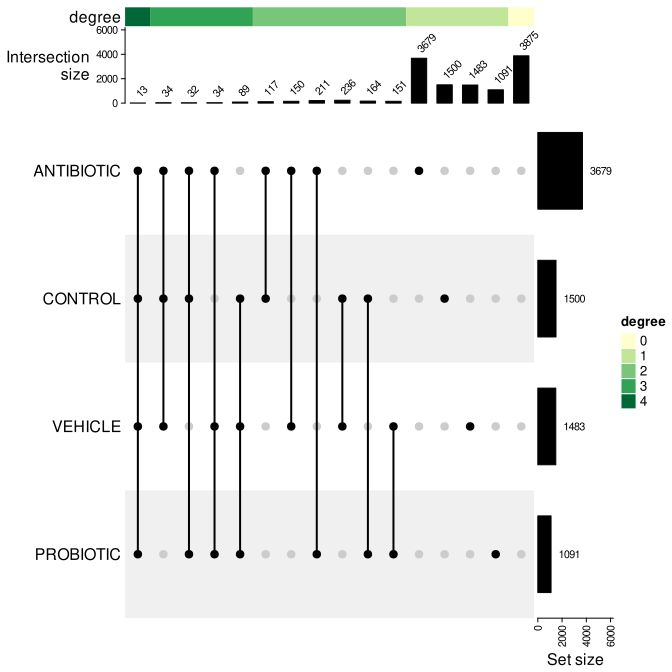
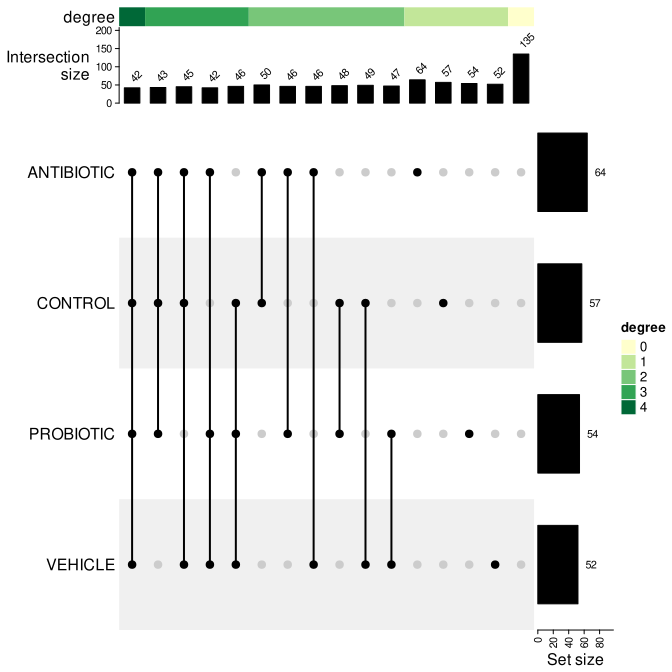
A seguir, comparamos as ASVs compartilhadas entre as amostras considerando os dados completos e posteriormente os dados após o procedimento de rarefação descrito na seção anterior.
Aglomeração de ASVs da mesma taxonomia
Após a utilização da função tax_glom() selecionando o nível de gênero, na tabela de ASVs temos 210 registros.
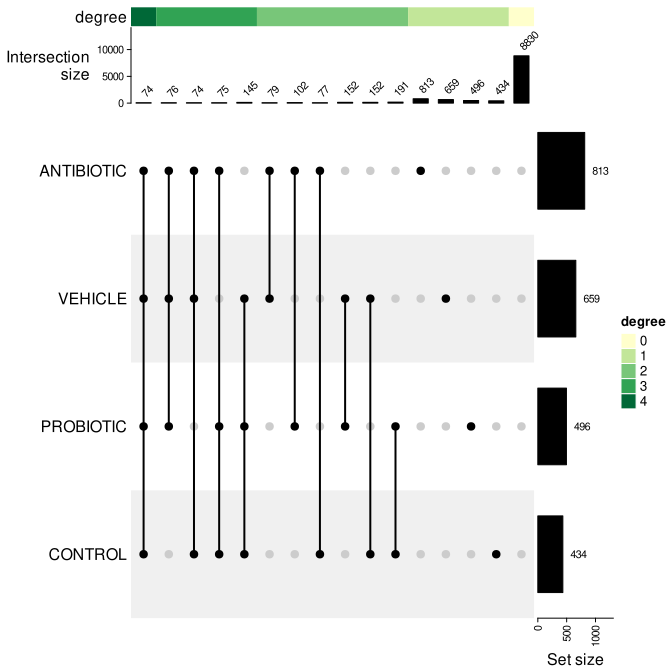
Análise de intersecção
As análises de intersecção a seguir estão organizadas por grupos de amostras (SEGMENTO), portanto, os números relacionados ao grau zero de intersecção são as que não entraram na comparação, estão nos demais grupos.
Composição taxonômica
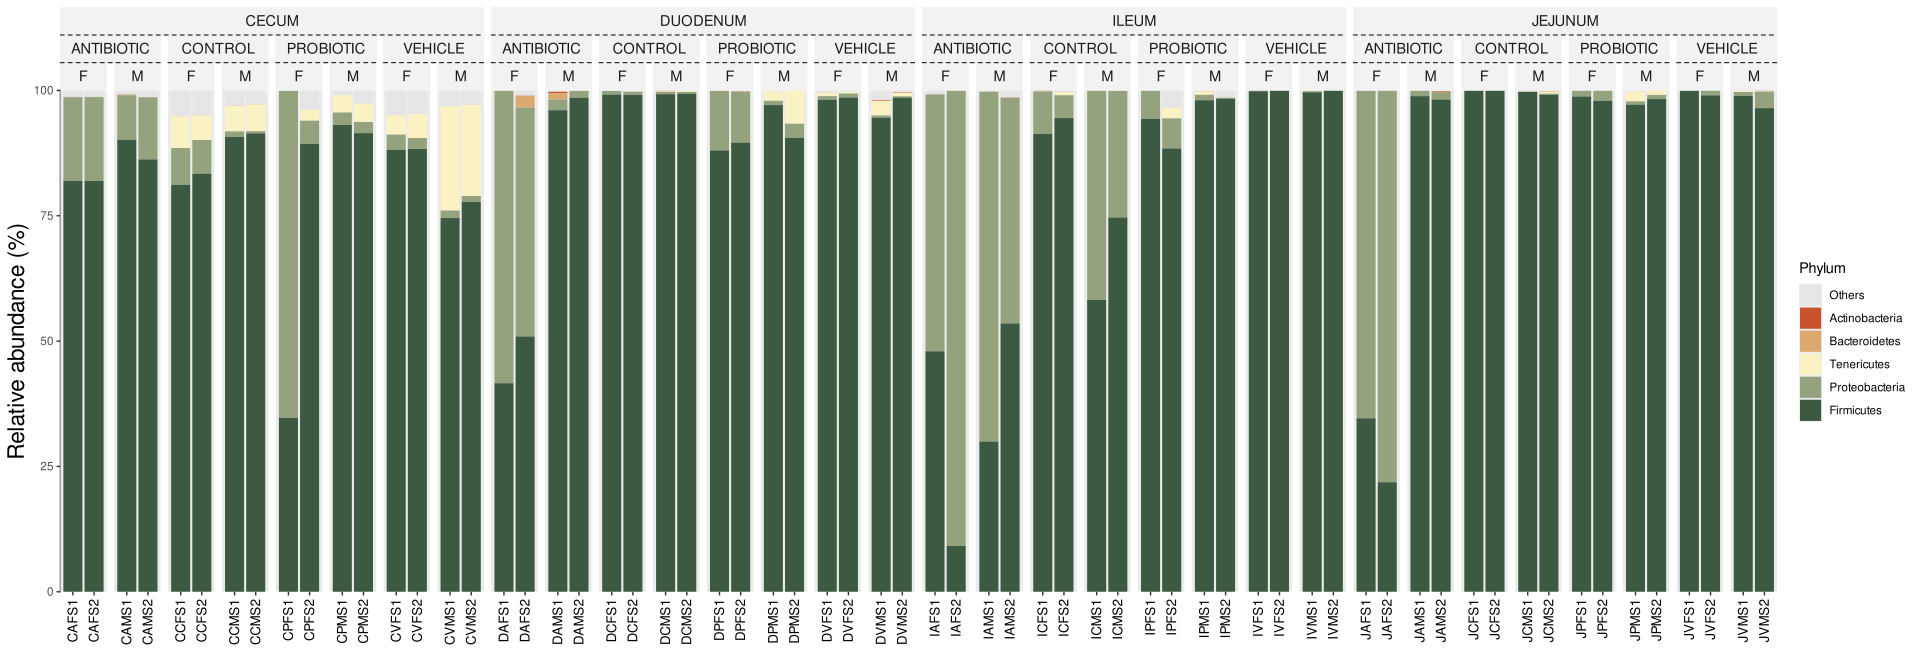
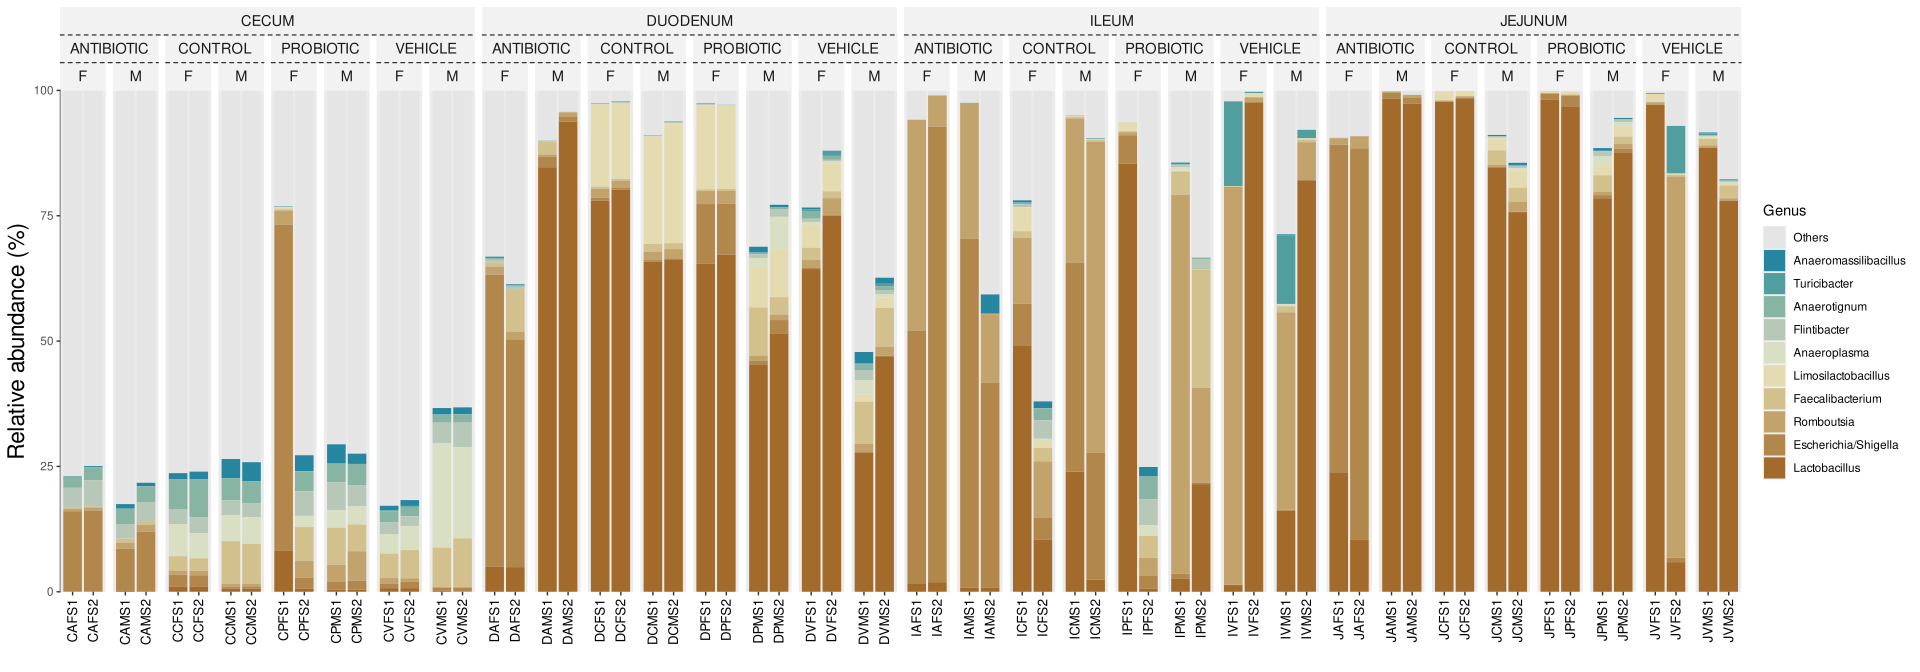
A seguir temos a composição dos mais abundantes filos e gêneros em cada amostras (Figure 8). Os gráficos foram gerados a partir do pacote microeco v1.6.0. Para isso, o objeto phyloseq foi convertido para um objeto microeco por meio da função phyloseq2meco() do pacote file2meco v0.7.1.
Alfa diversidade
Os índices de alfa diversidade (“observed”, “chao1”, “diversity_inverse_simpson”, “diversity_gini_simpson”, “diversity_shannon”, “diversity_fisher”, “diversity_coverage”, “evenness_camargo”, “evenness_pielou”, “evenness_simpson”, “evenness_evar”, “evenness_bulla”, “dominance_dbp”, “dominance_dmn”, “dominance_absolute”, “dominance_relative”, “dominance_simpson”, “dominance_core_abundance”, “dominance_gini”, “rarity_log_modulo_skewness”, “rarity_low_abundance”, “rarity_rare_abundance”, “PD”) foram obtidos com a função alpha() do pacote microbiome v.1.16.0. No resultado, há métricas para avaliar riqueza, diversidade, equitabilidade, dominância e raridade. Além disso, também foi calculada uma métrica de diversidade filogenética (Faith’s Phylogenetic Diversity), calculada pela função pd() pacote picante v1.8.2. O resultado (Table 6) foi incorporado também à planilha “Alpha Diversity Indices” do Excel (Section 3.13.8.3).
Para informações sobre os índices de diversidade, incluindo a forma como interpretar os resultados, consulte a seção “Indices of diversity and eveness” da página “Analysis of community ecology data in R” de David Zelený”.
Índices de Alfa diversidade
- Riqueza (referem-se à quantidade de diferentes taxa):
- observed;
- chao1;
- Diversidade:
- inverse_simpson;
- gini_simpson;
- shannon;
- fisher;
- coverage (refere-se ao número de grupos necessários para terem uma determinada proporção no ecossistema, aqui foi utilizado o valor pré-determinado de 0,5, i.e. 50%);
- PD: Faith’s Phylogenetic Diversity (calcula a soma do comprimento das ramificações dentro de uma amostra);
- Dominância (referem-se à abundância dos taxa mais abundantes):
- dbp;
- dmn;
- absolute;
- relative;
- simpson;
- core_abundance (refere-se à proporção relativa dos taxa essenciais “core”, i.e. função core_abundance() com os parâmetros: detection = .1/100 e prevalence = 45/100);
- gini;
- Raridade e baixa abundância (quantificam a concentração de taxa raros ou pouco abundantes):
- log_modulo_skewness;
- low_abundance;
- rare_abundance (complemento de core_abundance: 1-core_abundance(), considerando os parâmetros: detection = 0.2/100, prevalence = 20/100);
- Equitabilidade:
- camargo;
- pielou;
- simpson;
- evar;
- bulla;
| observed | chao1 | diversity_inverse_simpson | diversity_gini_simpson | diversity_shannon | diversity_fisher | diversity_coverage | evenness_camargo | evenness_pielou | evenness_simpson | evenness_evar | evenness_bulla | dominance_dbp | dominance_dmn | dominance_absolute | dominance_relative | dominance_simpson | dominance_core_abundance | dominance_gini | rarity_log_modulo_skewness | rarity_low_abundance | rarity_rare_abundance | PD | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| CAFS1 | 1434 | 1550.41 | 787.58 | 0.9987 | 6.888 | 328.250 | 296 | 0.7149 | 0.9476 | 0.5492 | 0.3903 | 0.6519 | 0.0048 | 0.0088 | 123 | 0.0048 | 0.0013 | 0.0000 | 0.9302 | 1.9079 | 0.8667 | 0.9449 | 557.39 |
| CAFS2 | 1219 | 1306.85 | 724.36 | 0.9986 | 6.779 | 266.461 | 275 | 0.7428 | 0.9539 | 0.5942 | 0.4181 | 0.6795 | 0.0057 | 0.0101 | 145 | 0.0057 | 0.0014 | 0.0000 | 0.9367 | 1.8321 | 0.8286 | 0.9468 | 453.76 |
| CAMS1 | 1117 | 1176.73 | 699.73 | 0.9986 | 6.731 | 238.428 | 269 | 0.8130 | 0.9590 | 0.6264 | 0.4478 | 0.7100 | 0.0047 | 0.0089 | 120 | 0.0047 | 0.0014 | 0.0000 | 0.9389 | 1.7554 | 0.7822 | 0.9655 | 411.22 |
| CAMS2 | 1281 | 1360.46 | 808.79 | 0.9988 | 6.878 | 283.908 | 315 | 0.7706 | 0.9613 | 0.6314 | 0.4761 | 0.7117 | 0.0044 | 0.0087 | 112 | 0.0044 | 0.0012 | 0.0000 | 0.9290 | 1.8306 | 0.8779 | 0.9610 | 425.14 |
| CCFS1 | 483 | 491.75 | 259.62 | 0.9961 | 5.790 | 84.496 | 96 | 0.8720 | 0.9368 | 0.5375 | 0.3760 | 0.6324 | 0.0116 | 0.0213 | 298 | 0.0116 | 0.0039 | 0.0000 | 0.9769 | 1.5458 | 0.2501 | 0.9620 | 319.06 |
| CCFS2 | 406 | 409.00 | 220.88 | 0.9955 | 5.606 | 68.521 | 81 | 0.8967 | 0.9334 | 0.5440 | 0.3453 | 0.6274 | 0.0131 | 0.0233 | 335 | 0.0131 | 0.0045 | 0.0000 | 0.9808 | 1.4863 | 0.1918 | 0.9629 | 307.30 |
| CCMS1 | 461 | 476.81 | 245.94 | 0.9959 | 5.720 | 79.862 | 92 | 0.8688 | 0.9327 | 0.5335 | 0.3062 | 0.6355 | 0.0126 | 0.0241 | 322 | 0.0126 | 0.0041 | 0.0059 | 0.9783 | 1.5119 | 0.2059 | 0.9899 | 338.98 |
| CCMS2 | 404 | 406.55 | 223.07 | 0.9955 | 5.605 | 68.116 | 85 | 0.9442 | 0.9339 | 0.5522 | 0.3356 | 0.6328 | 0.0133 | 0.0245 | 341 | 0.0133 | 0.0045 | 0.0000 | 0.9807 | 1.5021 | 0.1590 | 0.9893 | 304.21 |
| CPFS1 | 214 | 214.00 | 133.85 | 0.9925 | 5.085 | 32.013 | 53 | 0.6929 | 0.9477 | 0.6254 | 0.4496 | 0.7117 | 0.0206 | 0.0385 | 527 | 0.0206 | 0.0075 | 0.0267 | 0.9882 | 1.0888 | 0.0460 | 0.6829 | 98.56 |
| CPFS2 | 257 | 270.75 | 132.88 | 0.9925 | 5.087 | 39.727 | 50 | 0.9546 | 0.9168 | 0.5170 | 0.2582 | 0.6001 | 0.0165 | 0.0325 | 422 | 0.0165 | 0.0075 | 0.0000 | 0.9886 | 1.6137 | 0.0785 | 0.9676 | 261.34 |
| CPMS1 | 368 | 378.46 | 198.35 | 0.9950 | 5.486 | 60.899 | 75 | 0.8964 | 0.9286 | 0.5390 | 0.2844 | 0.6223 | 0.0149 | 0.0280 | 381 | 0.0149 | 0.0050 | 0.0037 | 0.9829 | 1.5402 | 0.1367 | 0.9677 | 302.52 |
| CPMS2 | 313 | 317.00 | 155.94 | 0.9936 | 5.298 | 50.195 | 62 | 0.9233 | 0.9220 | 0.4982 | 0.2959 | 0.6191 | 0.0230 | 0.0420 | 588 | 0.0230 | 0.0064 | 0.0000 | 0.9858 | 1.5020 | 0.1045 | 0.9452 | 272.95 |
| CVFS1 | 426 | 431.35 | 233.16 | 0.9957 | 5.653 | 72.604 | 87 | 0.9136 | 0.9338 | 0.5473 | 0.3250 | 0.6335 | 0.0107 | 0.0206 | 274 | 0.0107 | 0.0043 | 0.0059 | 0.9798 | 1.5527 | 0.1847 | 0.9790 | 321.50 |
| CVFS2 | 457 | 467.20 | 244.68 | 0.9959 | 5.719 | 79.025 | 91 | 0.8596 | 0.9338 | 0.5354 | 0.3298 | 0.6312 | 0.0123 | 0.0238 | 315 | 0.0123 | 0.0041 | 0.0063 | 0.9784 | 1.4945 | 0.2263 | 0.9821 | 340.34 |
| CVMS1 | 400 | 402.10 | 248.97 | 0.9960 | 5.680 | 67.306 | 95 | 0.9471 | 0.9480 | 0.6224 | 0.3861 | 0.6927 | 0.0091 | 0.0182 | 234 | 0.0091 | 0.0040 | 0.0019 | 0.9788 | 1.3537 | 0.1480 | 0.9906 | 295.31 |
| CVMS2 | 441 | 458.14 | 261.85 | 0.9962 | 5.736 | 75.697 | 98 | 0.9056 | 0.9420 | 0.5938 | 0.3383 | 0.6670 | 0.0090 | 0.0179 | 229 | 0.0090 | 0.0038 | 0.0000 | 0.9777 | 1.4720 | 0.1747 | 0.9916 | 324.21 |
| DAFS1 | 390 | 392.55 | 248.89 | 0.9960 | 5.662 | 65.290 | 95 | 0.5719 | 0.9491 | 0.6382 | 0.3736 | 0.6899 | 0.0096 | 0.0173 | 245 | 0.0096 | 0.0040 | 0.0000 | 0.9791 | 1.3740 | 0.1398 | 0.7705 | 306.56 |
| DAFS2 | 309 | 309.30 | 150.98 | 0.9934 | 5.292 | 49.432 | 61 | 0.6638 | 0.9229 | 0.4886 | 0.3223 | 0.6409 | 0.0224 | 0.0413 | 574 | 0.0224 | 0.0066 | 0.0000 | 0.9857 | 1.5236 | 0.0815 | 0.8006 | 321.22 |
| DAMS1 | 200 | 210.11 | 89.59 | 0.9888 | 4.637 | 29.568 | 37 | 0.4322 | 0.8752 | 0.4479 | 0.1610 | 0.4844 | 0.0192 | 0.0381 | 492 | 0.0192 | 0.0112 | 0.0000 | 0.9924 | 1.8818 | 0.0587 | 0.1538 | 321.55 |
| DAMS2 | 142 | 146.20 | 77.24 | 0.9871 | 4.430 | 19.822 | 33 | 0.5364 | 0.8939 | 0.5440 | 0.1479 | 0.5641 | 0.0204 | 0.0394 | 521 | 0.0204 | 0.0129 | 0.0000 | 0.9935 | 1.9041 | 0.0220 | 0.0928 | 171.89 |
| DCFS1 | 206 | 206.00 | 129.51 | 0.9923 | 5.055 | 30.612 | 56 | 0.6384 | 0.9488 | 0.6287 | 0.3917 | 0.7546 | 0.0255 | 0.0442 | 652 | 0.0255 | 0.0077 | 0.0700 | 0.9881 | 1.3564 | 0.0205 | 0.2238 | 149.96 |
| DCFS2 | 133 | 133.00 | 70.53 | 0.9858 | 4.514 | 18.371 | 26 | 0.5785 | 0.9231 | 0.5303 | 0.3487 | 0.6806 | 0.0398 | 0.0751 | 1019 | 0.0398 | 0.0142 | 0.0666 | 0.9933 | 1.2250 | 0.0141 | 0.1959 | 180.84 |
| DCMS1 | 316 | 316.86 | 203.82 | 0.9951 | 5.481 | 50.768 | 82 | 0.5557 | 0.9522 | 0.6450 | 0.4073 | 0.7248 | 0.0139 | 0.0272 | 356 | 0.0139 | 0.0049 | 0.0624 | 0.9822 | 1.2366 | 0.0729 | 0.3386 | 187.49 |
| DCMS2 | 176 | 176.00 | 91.49 | 0.9891 | 4.822 | 25.457 | 34 | 0.6297 | 0.9326 | 0.5198 | 0.5187 | 0.6873 | 0.0303 | 0.0580 | 775 | 0.0303 | 0.0109 | 0.0565 | 0.9908 | 1.3427 | 0.0275 | 0.3166 | 154.14 |
| DPFS1 | 221 | 221.00 | 145.66 | 0.9931 | 5.155 | 33.248 | 58 | 0.6039 | 0.9550 | 0.6591 | 0.4859 | 0.7466 | 0.0171 | 0.0337 | 438 | 0.0171 | 0.0069 | 0.0721 | 0.9871 | 1.2244 | 0.0279 | 0.2427 | 102.44 |
| DPFS2 | 209 | 212.33 | 131.48 | 0.9924 | 5.074 | 31.136 | 52 | 0.6493 | 0.9498 | 0.6291 | 0.3899 | 0.7422 | 0.0228 | 0.0398 | 584 | 0.0228 | 0.0076 | 0.0732 | 0.9879 | 1.3828 | 0.0179 | 0.2582 | 244.22 |
| DPMS1 | 227 | 227.00 | 124.37 | 0.9920 | 5.083 | 34.314 | 47 | 0.6739 | 0.9371 | 0.5479 | 0.4635 | 0.6798 | 0.0247 | 0.0460 | 631 | 0.0247 | 0.0080 | 0.0340 | 0.9883 | 1.2686 | 0.0553 | 0.5413 | 180.13 |
| DPMS2 | 176 | 176.00 | 88.87 | 0.9887 | 4.776 | 25.457 | 31 | 0.6515 | 0.9237 | 0.5049 | 0.4517 | 0.6473 | 0.0265 | 0.0522 | 678 | 0.0265 | 0.0113 | 0.0249 | 0.9914 | 1.1787 | 0.0367 | 0.4913 | 195.31 |
| DVFS1 | 166 | 166.00 | 99.12 | 0.9899 | 4.791 | 23.776 | 37 | 0.5999 | 0.9372 | 0.5971 | 0.4201 | 0.6913 | 0.0244 | 0.0459 | 625 | 0.0244 | 0.0101 | 0.0084 | 0.9913 | 0.9914 | 0.0417 | 0.3569 | 165.32 |
| DVFS2 | 212 | 212.00 | 112.60 | 0.9911 | 4.989 | 31.662 | 45 | 0.5423 | 0.9313 | 0.5311 | 0.3985 | 0.6796 | 0.0324 | 0.0540 | 829 | 0.0324 | 0.0089 | 0.0542 | 0.9893 | 1.1983 | 0.0448 | 0.2219 | 335.56 |
| DVMS1 | 286 | 289.00 | 154.67 | 0.9935 | 5.299 | 45.091 | 57 | 0.7697 | 0.9369 | 0.5408 | 0.4412 | 0.6651 | 0.0224 | 0.0382 | 574 | 0.0224 | 0.0065 | 0.0062 | 0.9856 | 1.2720 | 0.1190 | 0.7110 | 322.18 |
| DVMS2 | 252 | 252.25 | 127.06 | 0.9921 | 5.127 | 38.815 | 51 | 0.6490 | 0.9273 | 0.5042 | 0.3788 | 0.6595 | 0.0322 | 0.0508 | 823 | 0.0322 | 0.0079 | 0.0493 | 0.9878 | 1.2668 | 0.0782 | 0.5210 | 233.13 |
| IAFS1 | 290 | 290.86 | 209.36 | 0.9952 | 5.458 | 45.841 | 82 | 0.5675 | 0.9626 | 0.7219 | 0.4538 | 0.7355 | 0.0102 | 0.0200 | 262 | 0.0102 | 0.0048 | 0.0000 | 0.9825 | 1.2205 | 0.1051 | 0.7248 | 62.36 |
| IAFS2 | 235 | 237.00 | 145.05 | 0.9931 | 5.138 | 35.743 | 55 | 0.5992 | 0.9411 | 0.6172 | 0.3944 | 0.6706 | 0.0152 | 0.0279 | 388 | 0.0152 | 0.0069 | 0.0000 | 0.9878 | 1.2702 | 0.0725 | 0.6750 | 61.03 |
| IAMS1 | 270 | 272.33 | 200.59 | 0.9950 | 5.394 | 42.116 | 79 | 0.5879 | 0.9635 | 0.7429 | 0.3626 | 0.7708 | 0.0103 | 0.0201 | 264 | 0.0103 | 0.0050 | 0.0000 | 0.9832 | 1.2370 | 0.0271 | 0.7087 | 87.77 |
| IAMS2 | 728 | 736.00 | 442.19 | 0.9977 | 6.295 | 139.554 | 167 | 0.5648 | 0.9552 | 0.6074 | 0.5083 | 0.6896 | 0.0075 | 0.0141 | 193 | 0.0075 | 0.0023 | 0.0000 | 0.9610 | 1.6161 | 0.5142 | 0.8283 | 199.73 |
| ICFS1 | 216 | 219.00 | 131.50 | 0.9924 | 5.051 | 32.365 | 49 | 0.6024 | 0.9398 | 0.6088 | 0.3848 | 0.6844 | 0.0160 | 0.0319 | 410 | 0.0160 | 0.0076 | 0.0647 | 0.9888 | 1.1804 | 0.0573 | 0.4161 | 164.25 |
| ICFS2 | 264 | 264.50 | 146.67 | 0.9932 | 5.189 | 41.010 | 54 | 0.7765 | 0.9307 | 0.5556 | 0.3876 | 0.6300 | 0.0146 | 0.0281 | 374 | 0.0146 | 0.0068 | 0.0276 | 0.9874 | 1.3335 | 0.1130 | 0.8465 | 226.51 |
| ICMS1 | 259 | 260.20 | 187.96 | 0.9947 | 5.368 | 40.093 | 76 | 0.6120 | 0.9659 | 0.7257 | 0.4824 | 0.7796 | 0.0150 | 0.0280 | 384 | 0.0150 | 0.0053 | 0.0328 | 0.9837 | 1.2780 | 0.0375 | 0.4787 | 95.75 |
| ICMS2 | 157 | 157.00 | 91.73 | 0.9891 | 4.726 | 22.279 | 38 | 0.6752 | 0.9347 | 0.5843 | 0.3521 | 0.6966 | 0.0290 | 0.0539 | 741 | 0.0290 | 0.0109 | 0.0000 | 0.9917 | 1.0855 | 0.0199 | 0.6762 | 98.84 |
| IPFS1 | 112 | 112.00 | 76.18 | 0.9869 | 4.464 | 15.057 | 33 | 0.5929 | 0.9460 | 0.6802 | 0.2889 | 0.7641 | 0.0342 | 0.0624 | 876 | 0.0342 | 0.0131 | 0.1730 | 0.9933 | 1.1140 | 0.0095 | 0.1146 | 75.28 |
| IPFS2 | 464 | 484.65 | 241.51 | 0.9959 | 5.693 | 80.491 | 90 | 0.8376 | 0.9272 | 0.5205 | 0.2825 | 0.6075 | 0.0118 | 0.0233 | 301 | 0.0118 | 0.0041 | 0.0058 | 0.9791 | 1.6282 | 0.1951 | 0.9557 | 353.10 |
| IPMS1 | 254 | 254.55 | 98.67 | 0.9899 | 4.908 | 39.179 | 38 | 0.4620 | 0.8864 | 0.3885 | 0.2662 | 0.5248 | 0.0323 | 0.0590 | 826 | 0.0323 | 0.0101 | 0.0030 | 0.9906 | 1.6311 | 0.1101 | 0.7599 | 207.00 |
| IPMS2 | 463 | 463.12 | 295.77 | 0.9966 | 5.877 | 80.281 | 115 | 0.6370 | 0.9575 | 0.6388 | 0.5357 | 0.7159 | 0.0121 | 0.0221 | 310 | 0.0121 | 0.0034 | 0.0383 | 0.9740 | 1.3686 | 0.2602 | 0.7368 | 210.93 |
| IVFS1 | 201 | 202.20 | 94.87 | 0.9895 | 4.810 | 29.741 | 37 | 0.5974 | 0.9070 | 0.4720 | 0.2845 | 0.5704 | 0.0311 | 0.0580 | 796 | 0.0311 | 0.0105 | 0.0104 | 0.9913 | 1.3739 | 0.0838 | 0.7681 | 92.59 |
| IVFS2 | 85 | 85.00 | 66.43 | 0.9849 | 4.290 | 10.959 | 29 | 0.6556 | 0.9657 | 0.7816 | 0.4300 | 0.8320 | 0.0364 | 0.0663 | 930 | 0.0364 | 0.0151 | 0.1743 | 0.9942 | 1.0817 | 0.0029 | 0.0137 | 42.05 |
| IVMS1 | 262 | 262.00 | 158.35 | 0.9937 | 5.276 | 40.643 | 61 | 0.6286 | 0.9474 | 0.6044 | 0.4974 | 0.7011 | 0.0195 | 0.0350 | 500 | 0.0195 | 0.0063 | 0.0226 | 0.9858 | 1.2263 | 0.0695 | 0.7582 | 130.09 |
| IVMS2 | 116 | 116.00 | 76.28 | 0.9869 | 4.483 | 15.680 | 32 | 0.5593 | 0.9430 | 0.6576 | 0.3954 | 0.7296 | 0.0356 | 0.0630 | 911 | 0.0356 | 0.0131 | 0.1415 | 0.9934 | 1.0218 | 0.0177 | 0.1632 | 65.41 |
| JAFS1 | 347 | 352.50 | 219.50 | 0.9954 | 5.533 | 56.765 | 84 | 0.5247 | 0.9460 | 0.6326 | 0.3160 | 0.6920 | 0.0104 | 0.0205 | 267 | 0.0104 | 0.0046 | 0.0000 | 0.9815 | 1.3138 | 0.0939 | 0.5532 | 138.42 |
| JAFS2 | 294 | 299.60 | 179.68 | 0.9944 | 5.365 | 46.593 | 66 | 0.5328 | 0.9440 | 0.6112 | 0.3591 | 0.6790 | 0.0134 | 0.0242 | 343 | 0.0134 | 0.0056 | 0.0000 | 0.9846 | 1.2130 | 0.1089 | 0.6311 | 109.23 |
| JAMS1 | 96 | 96.60 | 70.66 | 0.9858 | 4.308 | 12.605 | 31 | 0.6819 | 0.9438 | 0.7360 | 0.1965 | 0.7489 | 0.0228 | 0.0442 | 583 | 0.0228 | 0.0142 | 0.0000 | 0.9940 | 1.1555 | 0.0134 | 0.0314 | 46.67 |
| JAMS2 | 193 | 261.44 | 72.12 | 0.9861 | 4.357 | 28.358 | 31 | 0.3660 | 0.8278 | 0.3737 | 0.0941 | 0.3960 | 0.0226 | 0.0446 | 579 | 0.0226 | 0.0139 | 0.0000 | 0.9939 | 2.0213 | 0.0205 | 0.0426 | 256.88 |
| JCFS1 | 92 | 92.20 | 65.37 | 0.9847 | 4.287 | 12.003 | 28 | 0.6069 | 0.9480 | 0.7106 | 0.2204 | 0.7841 | 0.0362 | 0.0658 | 927 | 0.0362 | 0.0153 | 0.1562 | 0.9943 | 1.1586 | 0.0024 | 0.0225 | 64.16 |
| JCFS2 | 78 | 78.00 | 64.44 | 0.9845 | 4.252 | 9.931 | 28 | 0.6759 | 0.9759 | 0.8261 | 0.5104 | 0.8547 | 0.0368 | 0.0675 | 941 | 0.0368 | 0.0155 | 0.1949 | 0.9943 | 1.4196 | 0.0004 | 0.0118 | 30.86 |
| JCMS1 | 158 | 158.33 | 79.13 | 0.9874 | 4.558 | 22.445 | 33 | 0.4776 | 0.9003 | 0.5008 | 0.2397 | 0.5791 | 0.0327 | 0.0578 | 837 | 0.0327 | 0.0126 | 0.1526 | 0.9931 | 1.7222 | 0.0446 | 0.1532 | 167.17 |
| JCMS2 | 173 | 173.50 | 85.80 | 0.9883 | 4.667 | 24.951 | 34 | 0.4913 | 0.9056 | 0.4959 | 0.2752 | 0.5859 | 0.0305 | 0.0586 | 781 | 0.0305 | 0.0117 | 0.1523 | 0.9925 | 1.4485 | 0.0601 | 0.2385 | 175.98 |
| JPFS1 | 94 | 94.33 | 63.09 | 0.9842 | 4.292 | 12.303 | 27 | 0.5792 | 0.9446 | 0.6712 | 0.3025 | 0.7548 | 0.0391 | 0.0746 | 999 | 0.0391 | 0.0158 | 0.1722 | 0.9945 | 1.0725 | 0.0072 | 0.0157 | 43.80 |
| JPFS2 | 113 | 113.00 | 68.52 | 0.9854 | 4.396 | 15.213 | 28 | 0.5322 | 0.9299 | 0.6064 | 0.3209 | 0.6899 | 0.0385 | 0.0688 | 985 | 0.0385 | 0.0146 | 0.1548 | 0.9940 | 0.9813 | 0.0158 | 0.0285 | 46.87 |
| JPMS1 | 275 | 287.00 | 160.21 | 0.9938 | 5.243 | 43.042 | 63 | 0.5227 | 0.9335 | 0.5826 | 0.2980 | 0.6520 | 0.0154 | 0.0303 | 394 | 0.0154 | 0.0062 | 0.0696 | 0.9863 | 1.4336 | 0.0901 | 0.2323 | 209.76 |
| JPMS2 | 217 | 217.50 | 131.42 | 0.9924 | 5.051 | 32.542 | 53 | 0.5415 | 0.9389 | 0.6056 | 0.3405 | 0.6915 | 0.0227 | 0.0415 | 580 | 0.0227 | 0.0076 | 0.0858 | 0.9885 | 1.2873 | 0.0320 | 0.1172 | 146.34 |
| JVFS1 | 93 | 93.00 | 69.17 | 0.9855 | 4.335 | 12.153 | 30 | 0.6309 | 0.9564 | 0.7438 | 0.3250 | 0.8071 | 0.0359 | 0.0637 | 918 | 0.0359 | 0.0145 | 0.1376 | 0.9939 | 1.0746 | 0.0085 | 0.0290 | 55.08 |
| JVFS2 | 137 | 137.00 | 77.78 | 0.9871 | 4.569 | 19.014 | 33 | 0.7239 | 0.9286 | 0.5677 | 0.3440 | 0.6870 | 0.0382 | 0.0711 | 978 | 0.0382 | 0.0129 | 0.0283 | 0.9929 | 0.9789 | 0.0285 | 0.7432 | 98.22 |
| JVMS1 | 193 | 196.00 | 76.43 | 0.9869 | 4.579 | 28.358 | 31 | 0.3848 | 0.8700 | 0.3960 | 0.1940 | 0.4892 | 0.0369 | 0.0641 | 944 | 0.0369 | 0.0131 | 0.1802 | 0.9931 | 1.7818 | 0.0686 | 0.1101 | 214.07 |
| JVMS2 | 141 | 141.00 | 71.12 | 0.9859 | 4.515 | 19.660 | 29 | 0.5038 | 0.9124 | 0.5044 | 0.3319 | 0.6400 | 0.0391 | 0.0750 | 1000 | 0.0391 | 0.0141 | 0.1399 | 0.9934 | 1.2009 | 0.0478 | 0.2380 | 155.43 |
Comparações de Alfa diversidade
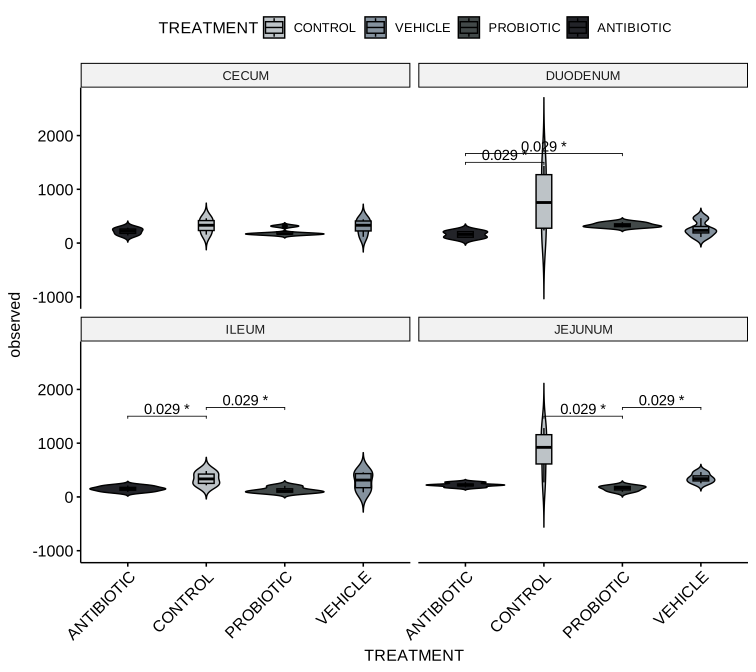
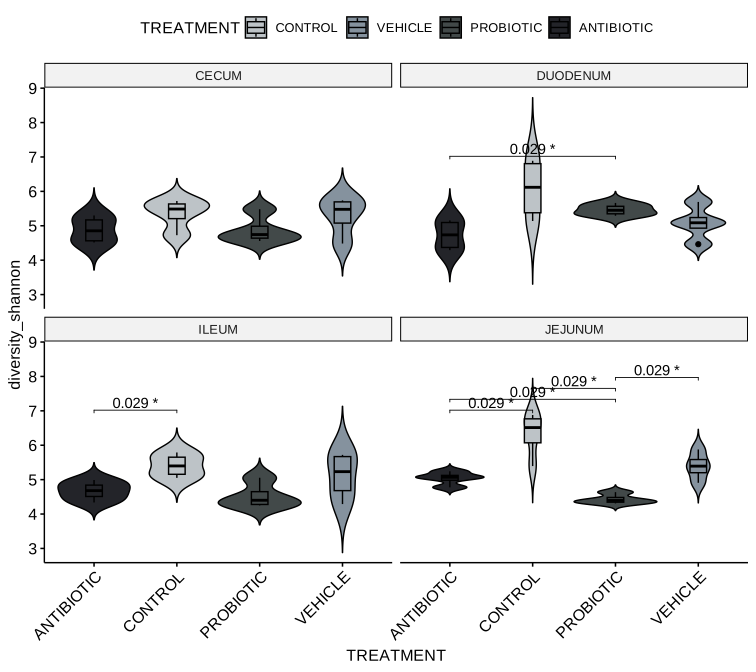
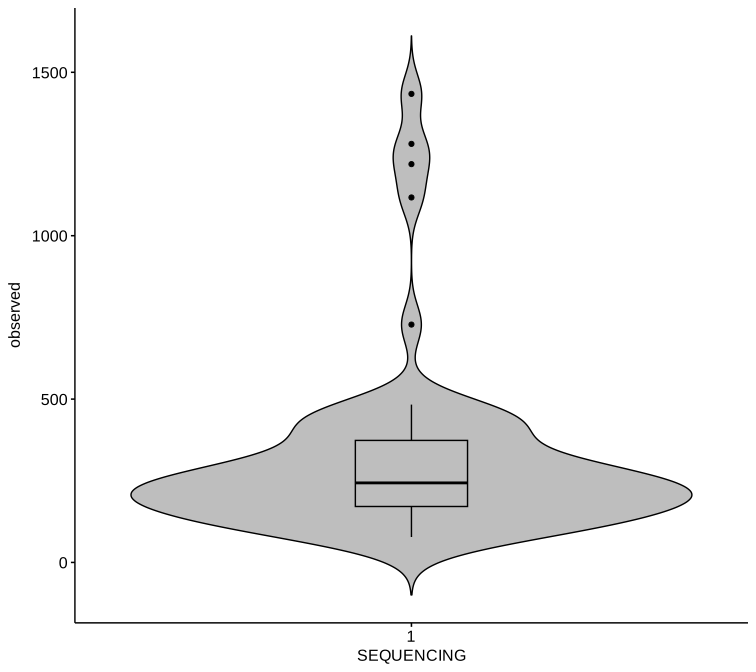
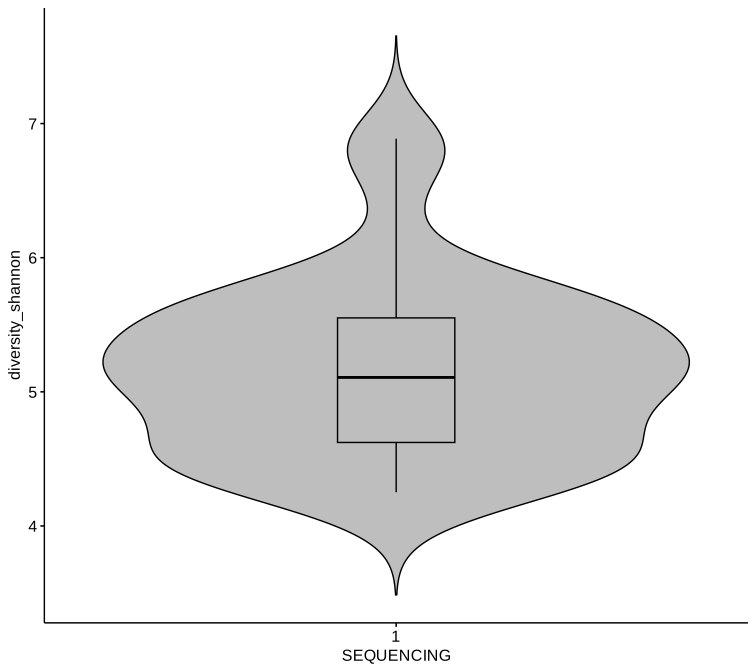
Também foram realizadas comparações entre as crianças considerando um índice de riqueza (observed) e um outro de diversidade (shannon). A Figure 9 exibe as diferenças referente a esses índices nas amotras por segmento do intestino e tratamento (SEGMENT_TREATMENT). Considerando cada amostra um ambiente, podemos considerar que a diversidade relacionada ao conjunto de todas as amostras (POOLs) como sendo a diversidade gama (Figure 10), ou seja, são os mesmos índices de diversidade alfa porém considerando todo o conjunto de amostras consideradas no sequenciamento.
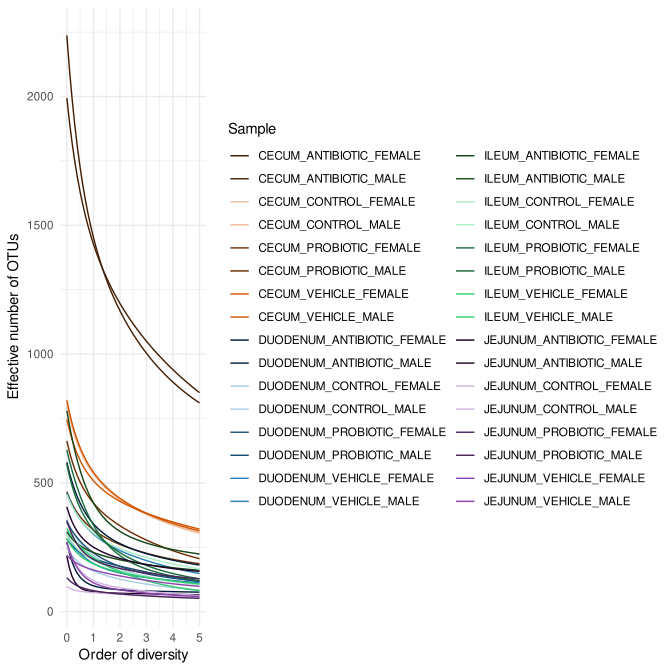
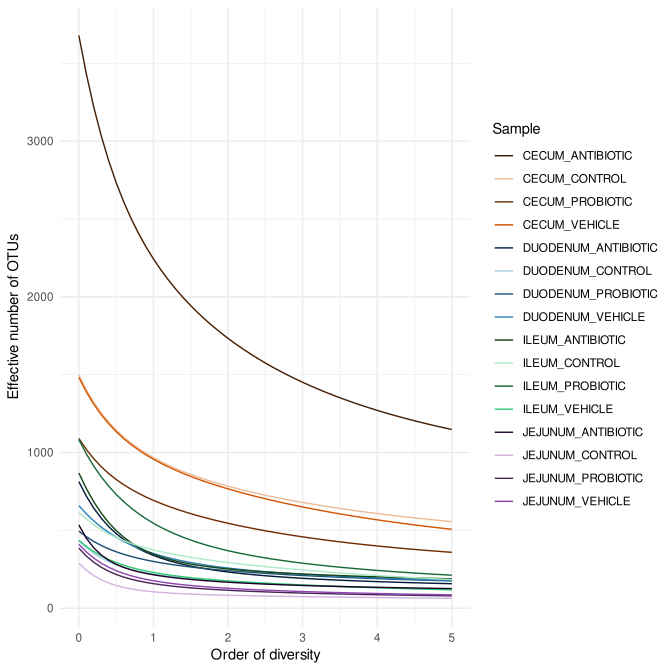
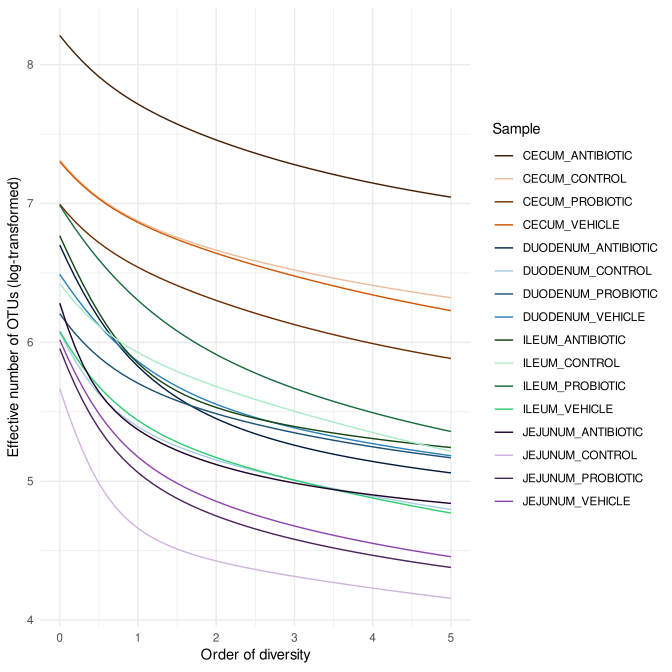
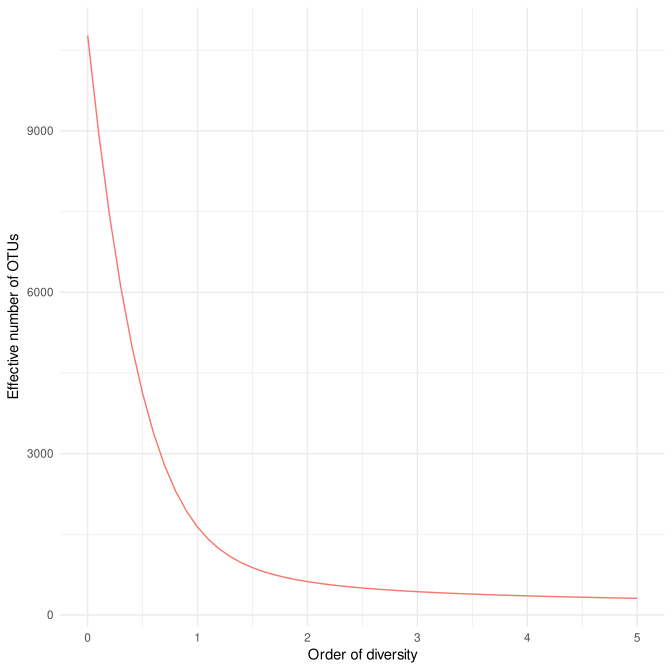
Um outro método para avaliação da alfa diversidade é a baseada nos números de Hill, portanto, realizamos uma análise com o pacote hilldiv v1.5.1 do R (Figure 11).
Beta diversidade
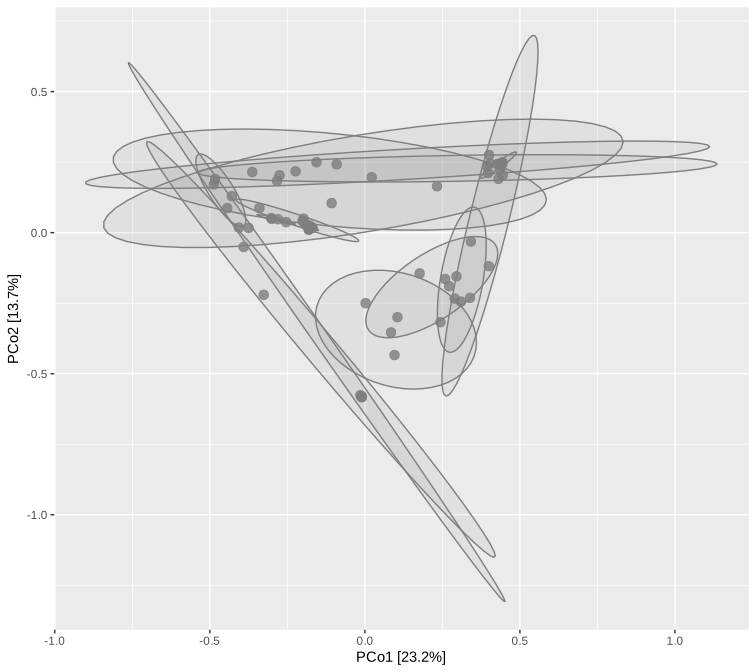
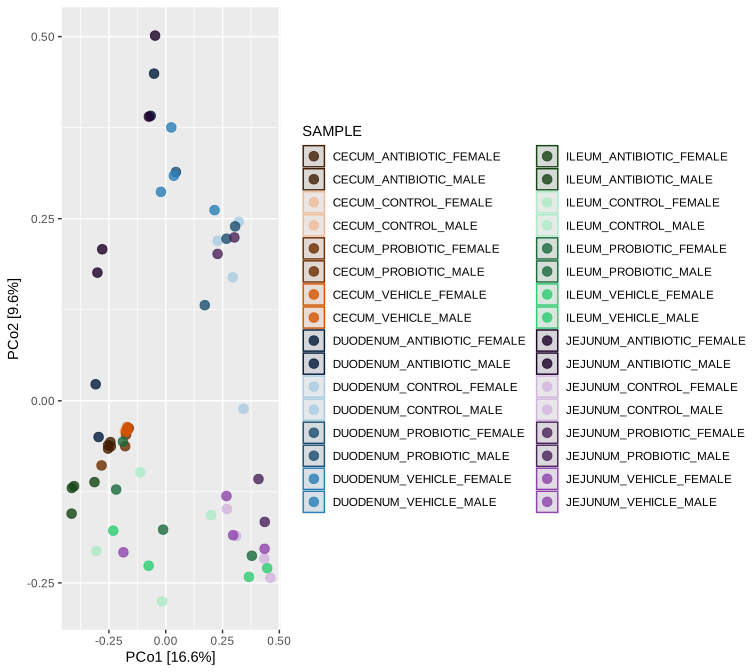
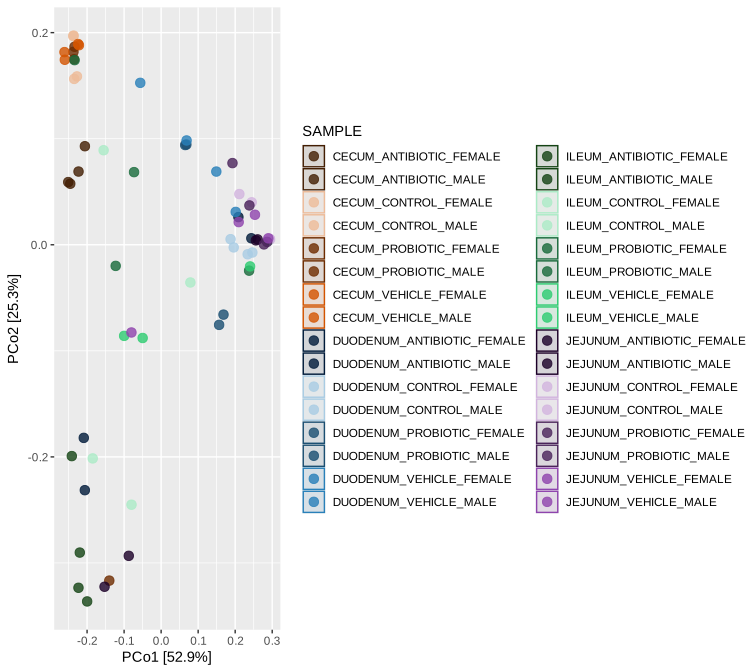
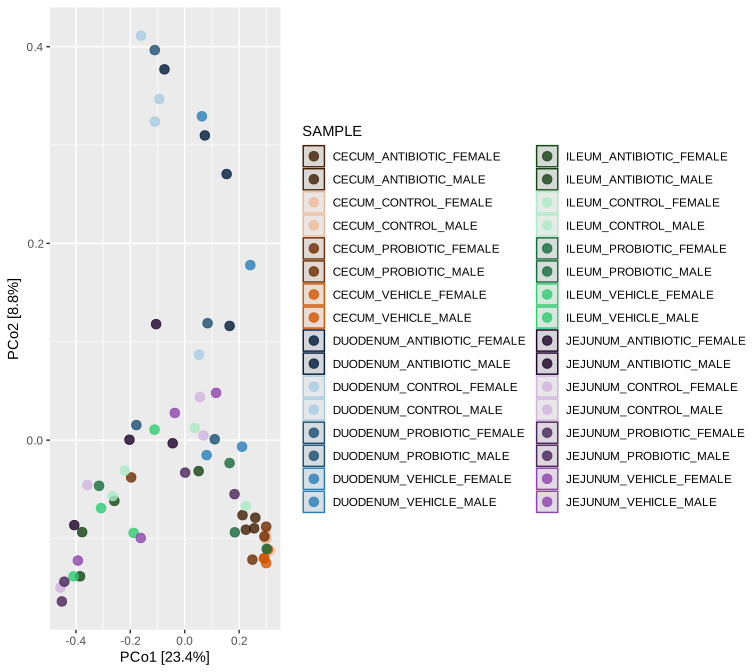
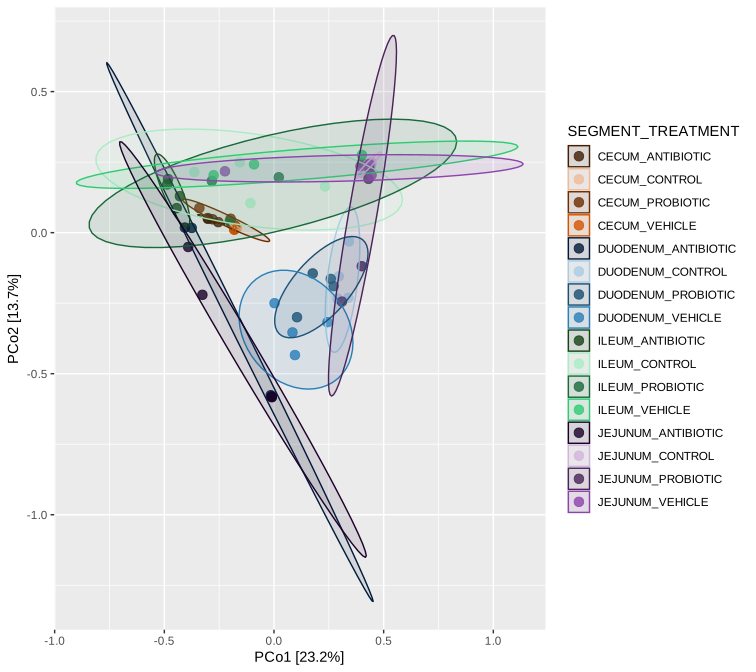
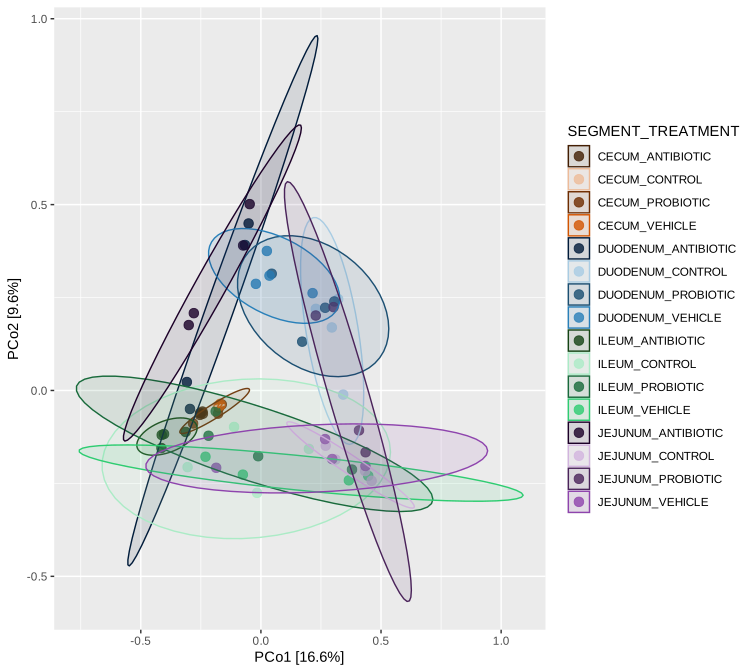
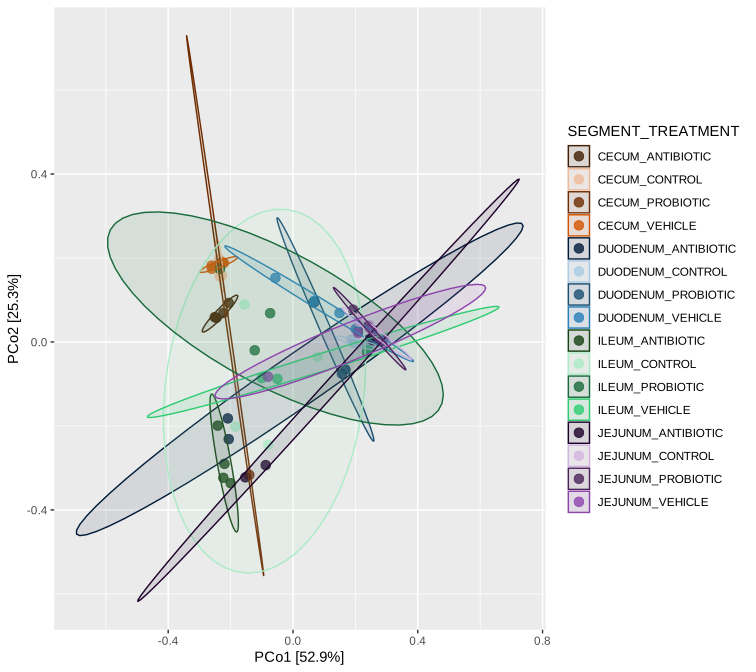
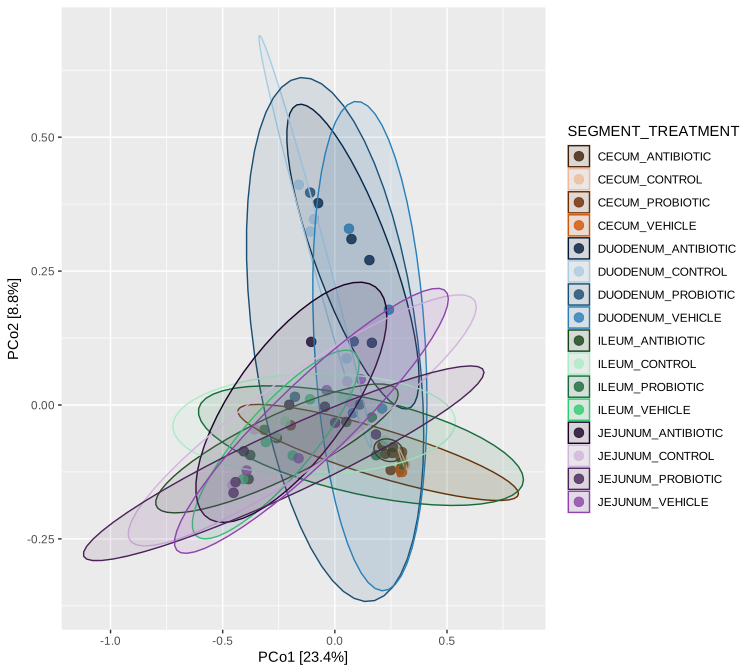
Também foram realizadas análises de Beta diversidade comparando as amostras usando Análises de Coordenadas Principais (PCoA) com distâncias categóricas de Jaccard (presença/ausência) e Bray-curtis (quantitativa), e as distâncias UniFrac que levam em conta as relações filogenéticas. As distâncias UniFrac consideradas foram a ponderada, em que as diferenças entre as abundâncias dos taxa são consideradas, e a não-ponderada, em que não se considera essas diferenças de abundâncias. Veja apresentação sobre distâncias neste link e métodos de ordenação neste link. A diversidade beta observada pode ser avaliada por meio das figuras a seguir (Figure 12 e Figure 13).
Análise de abundância diferencial
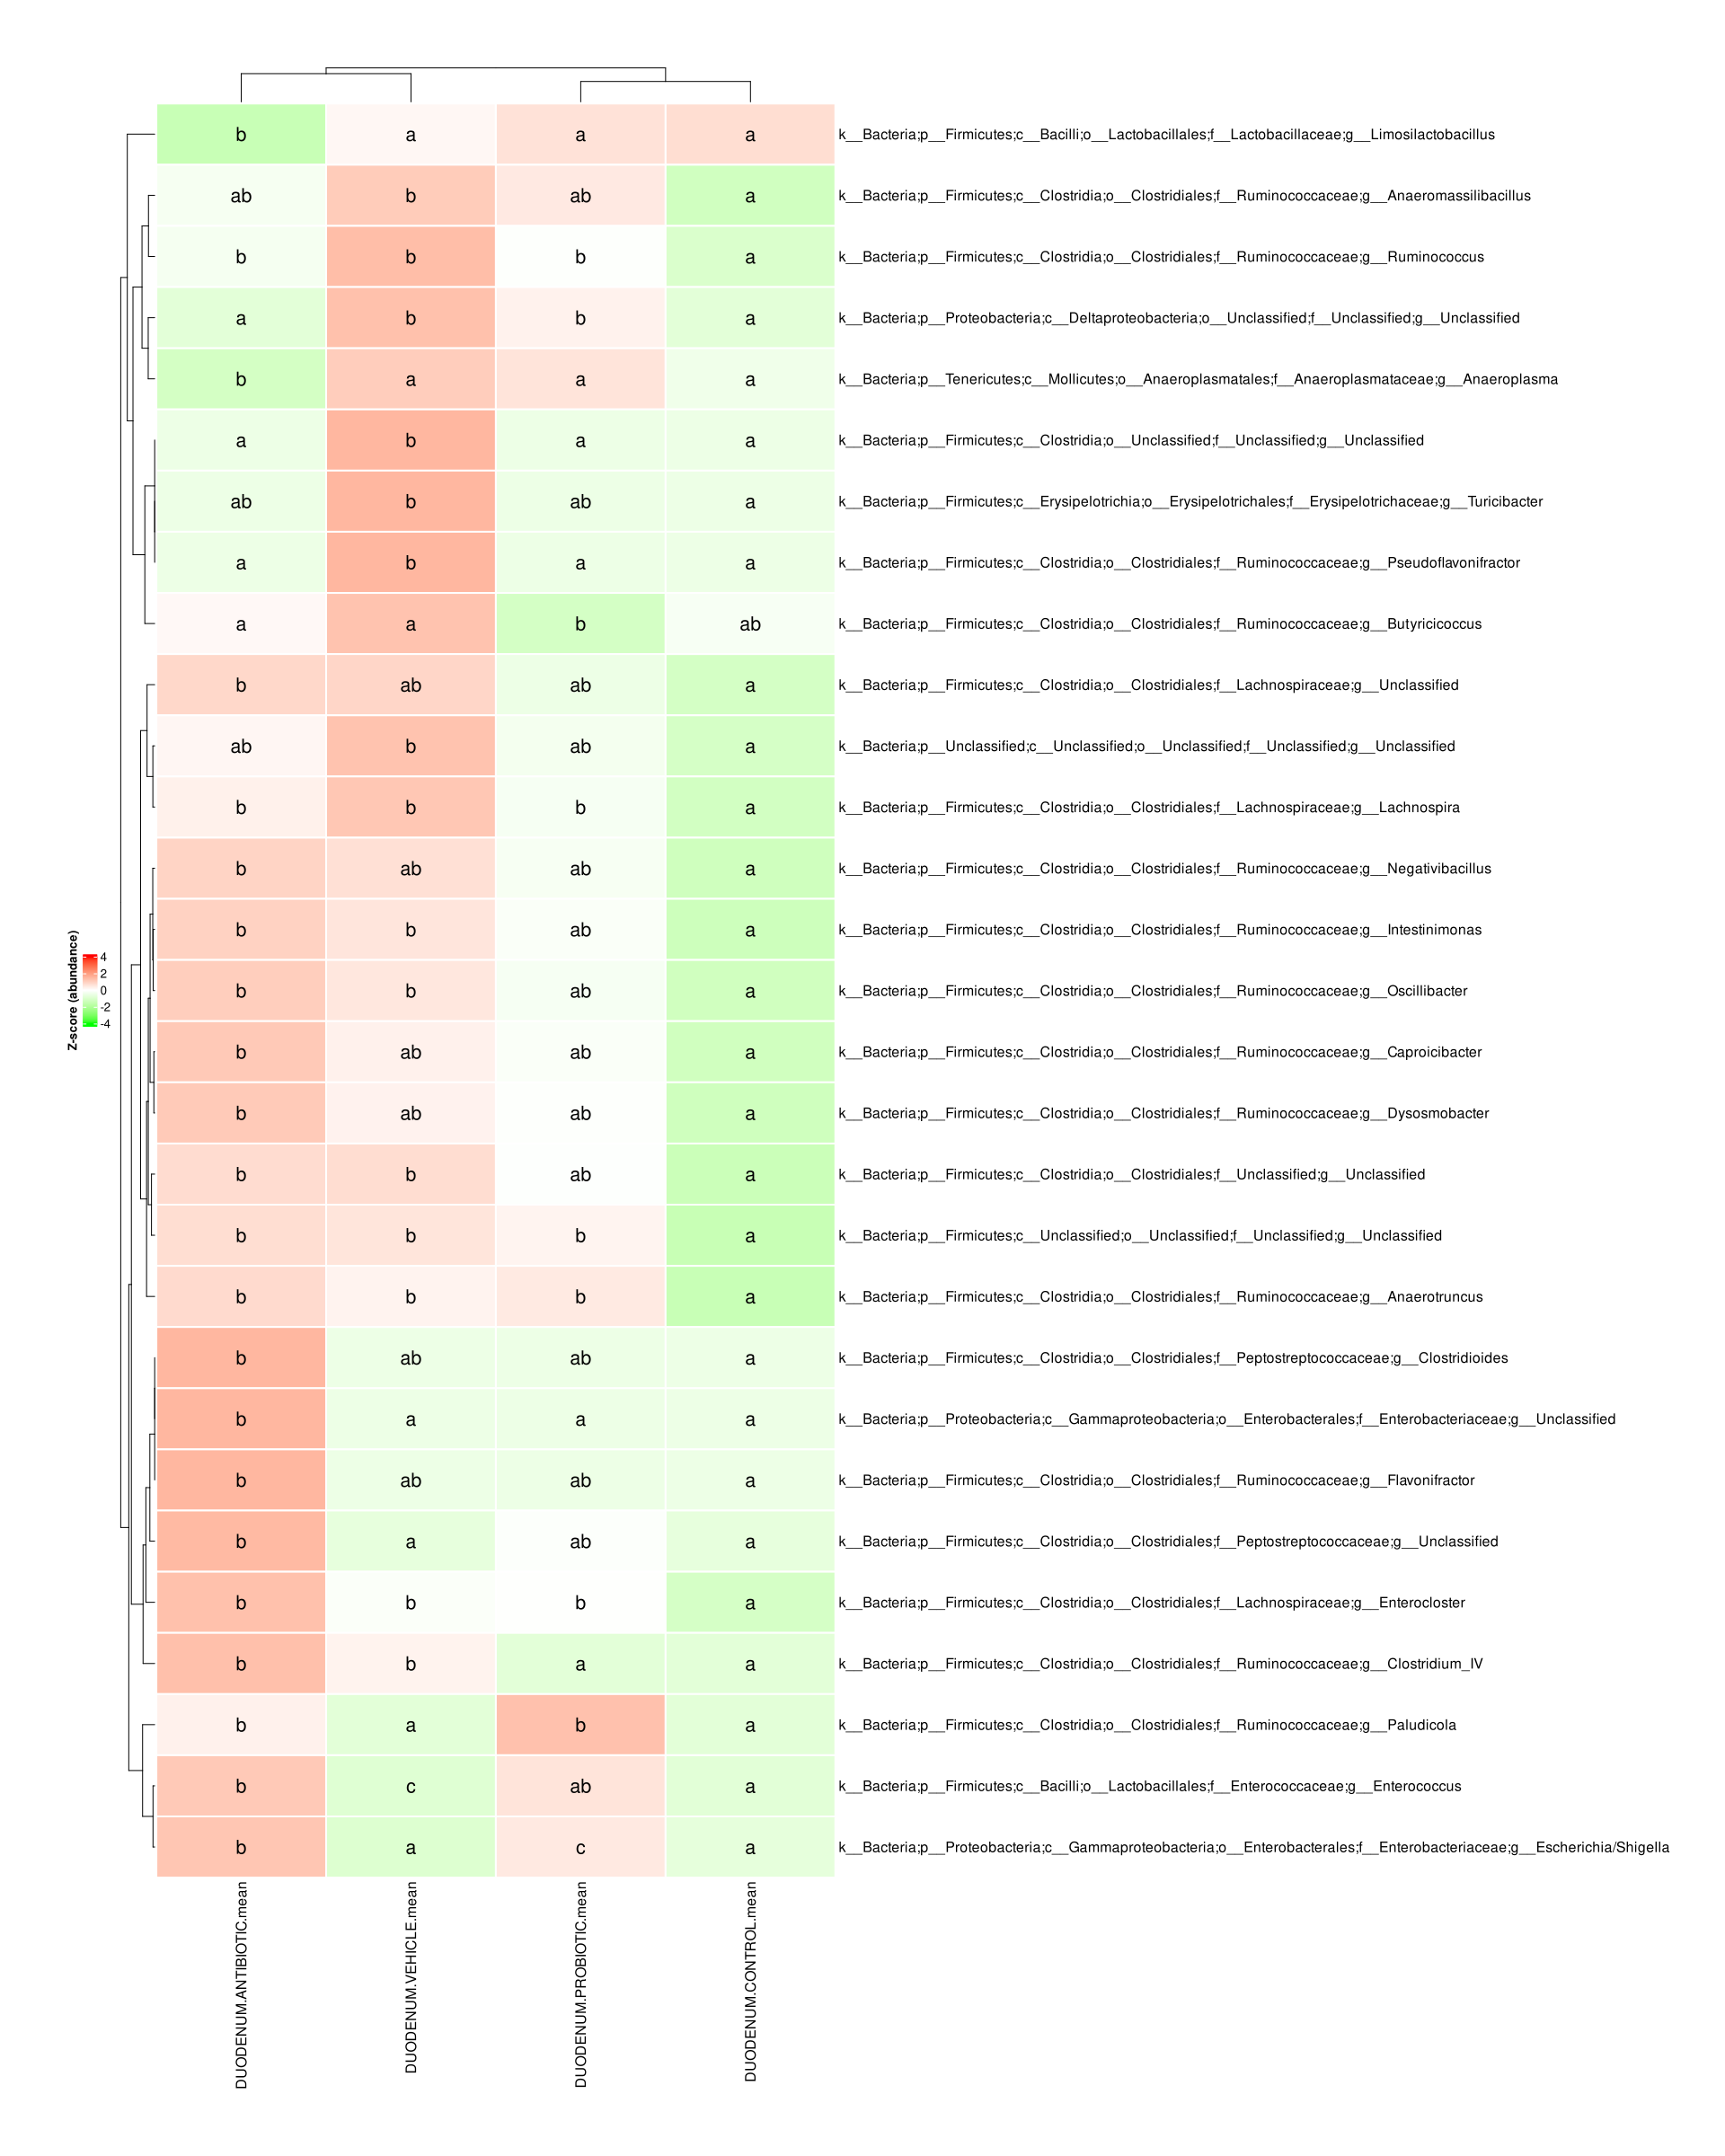
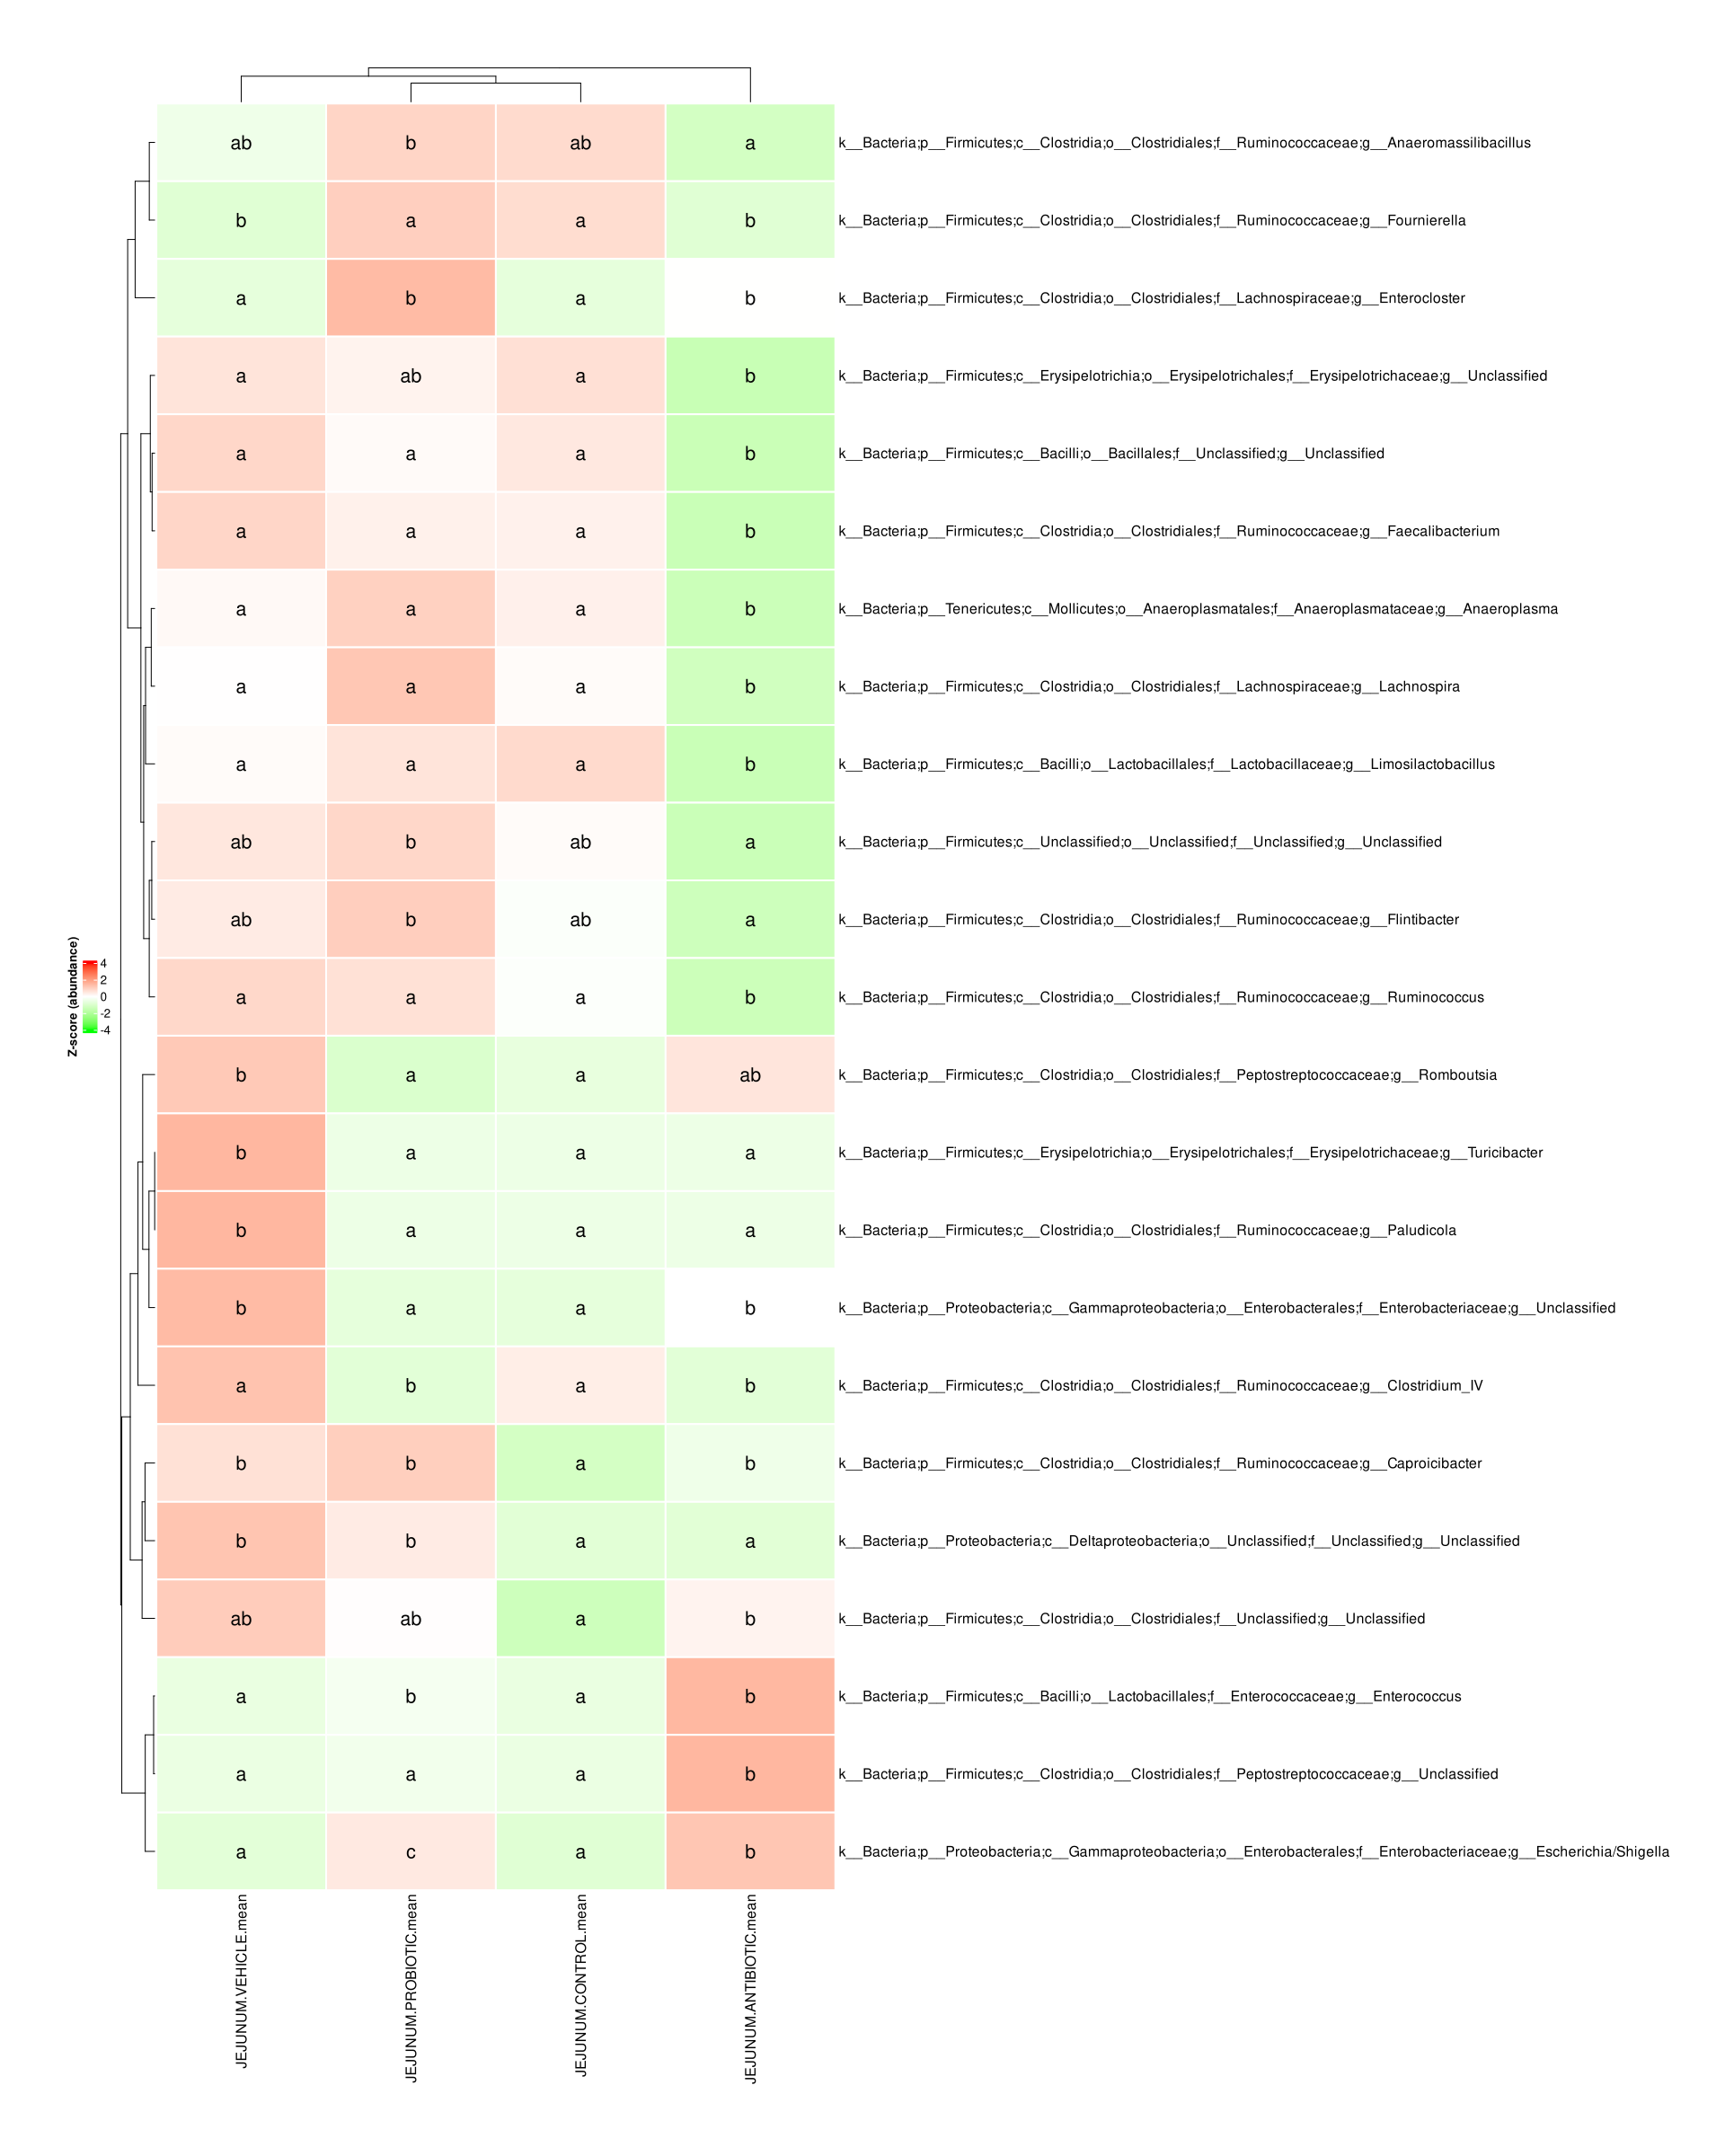
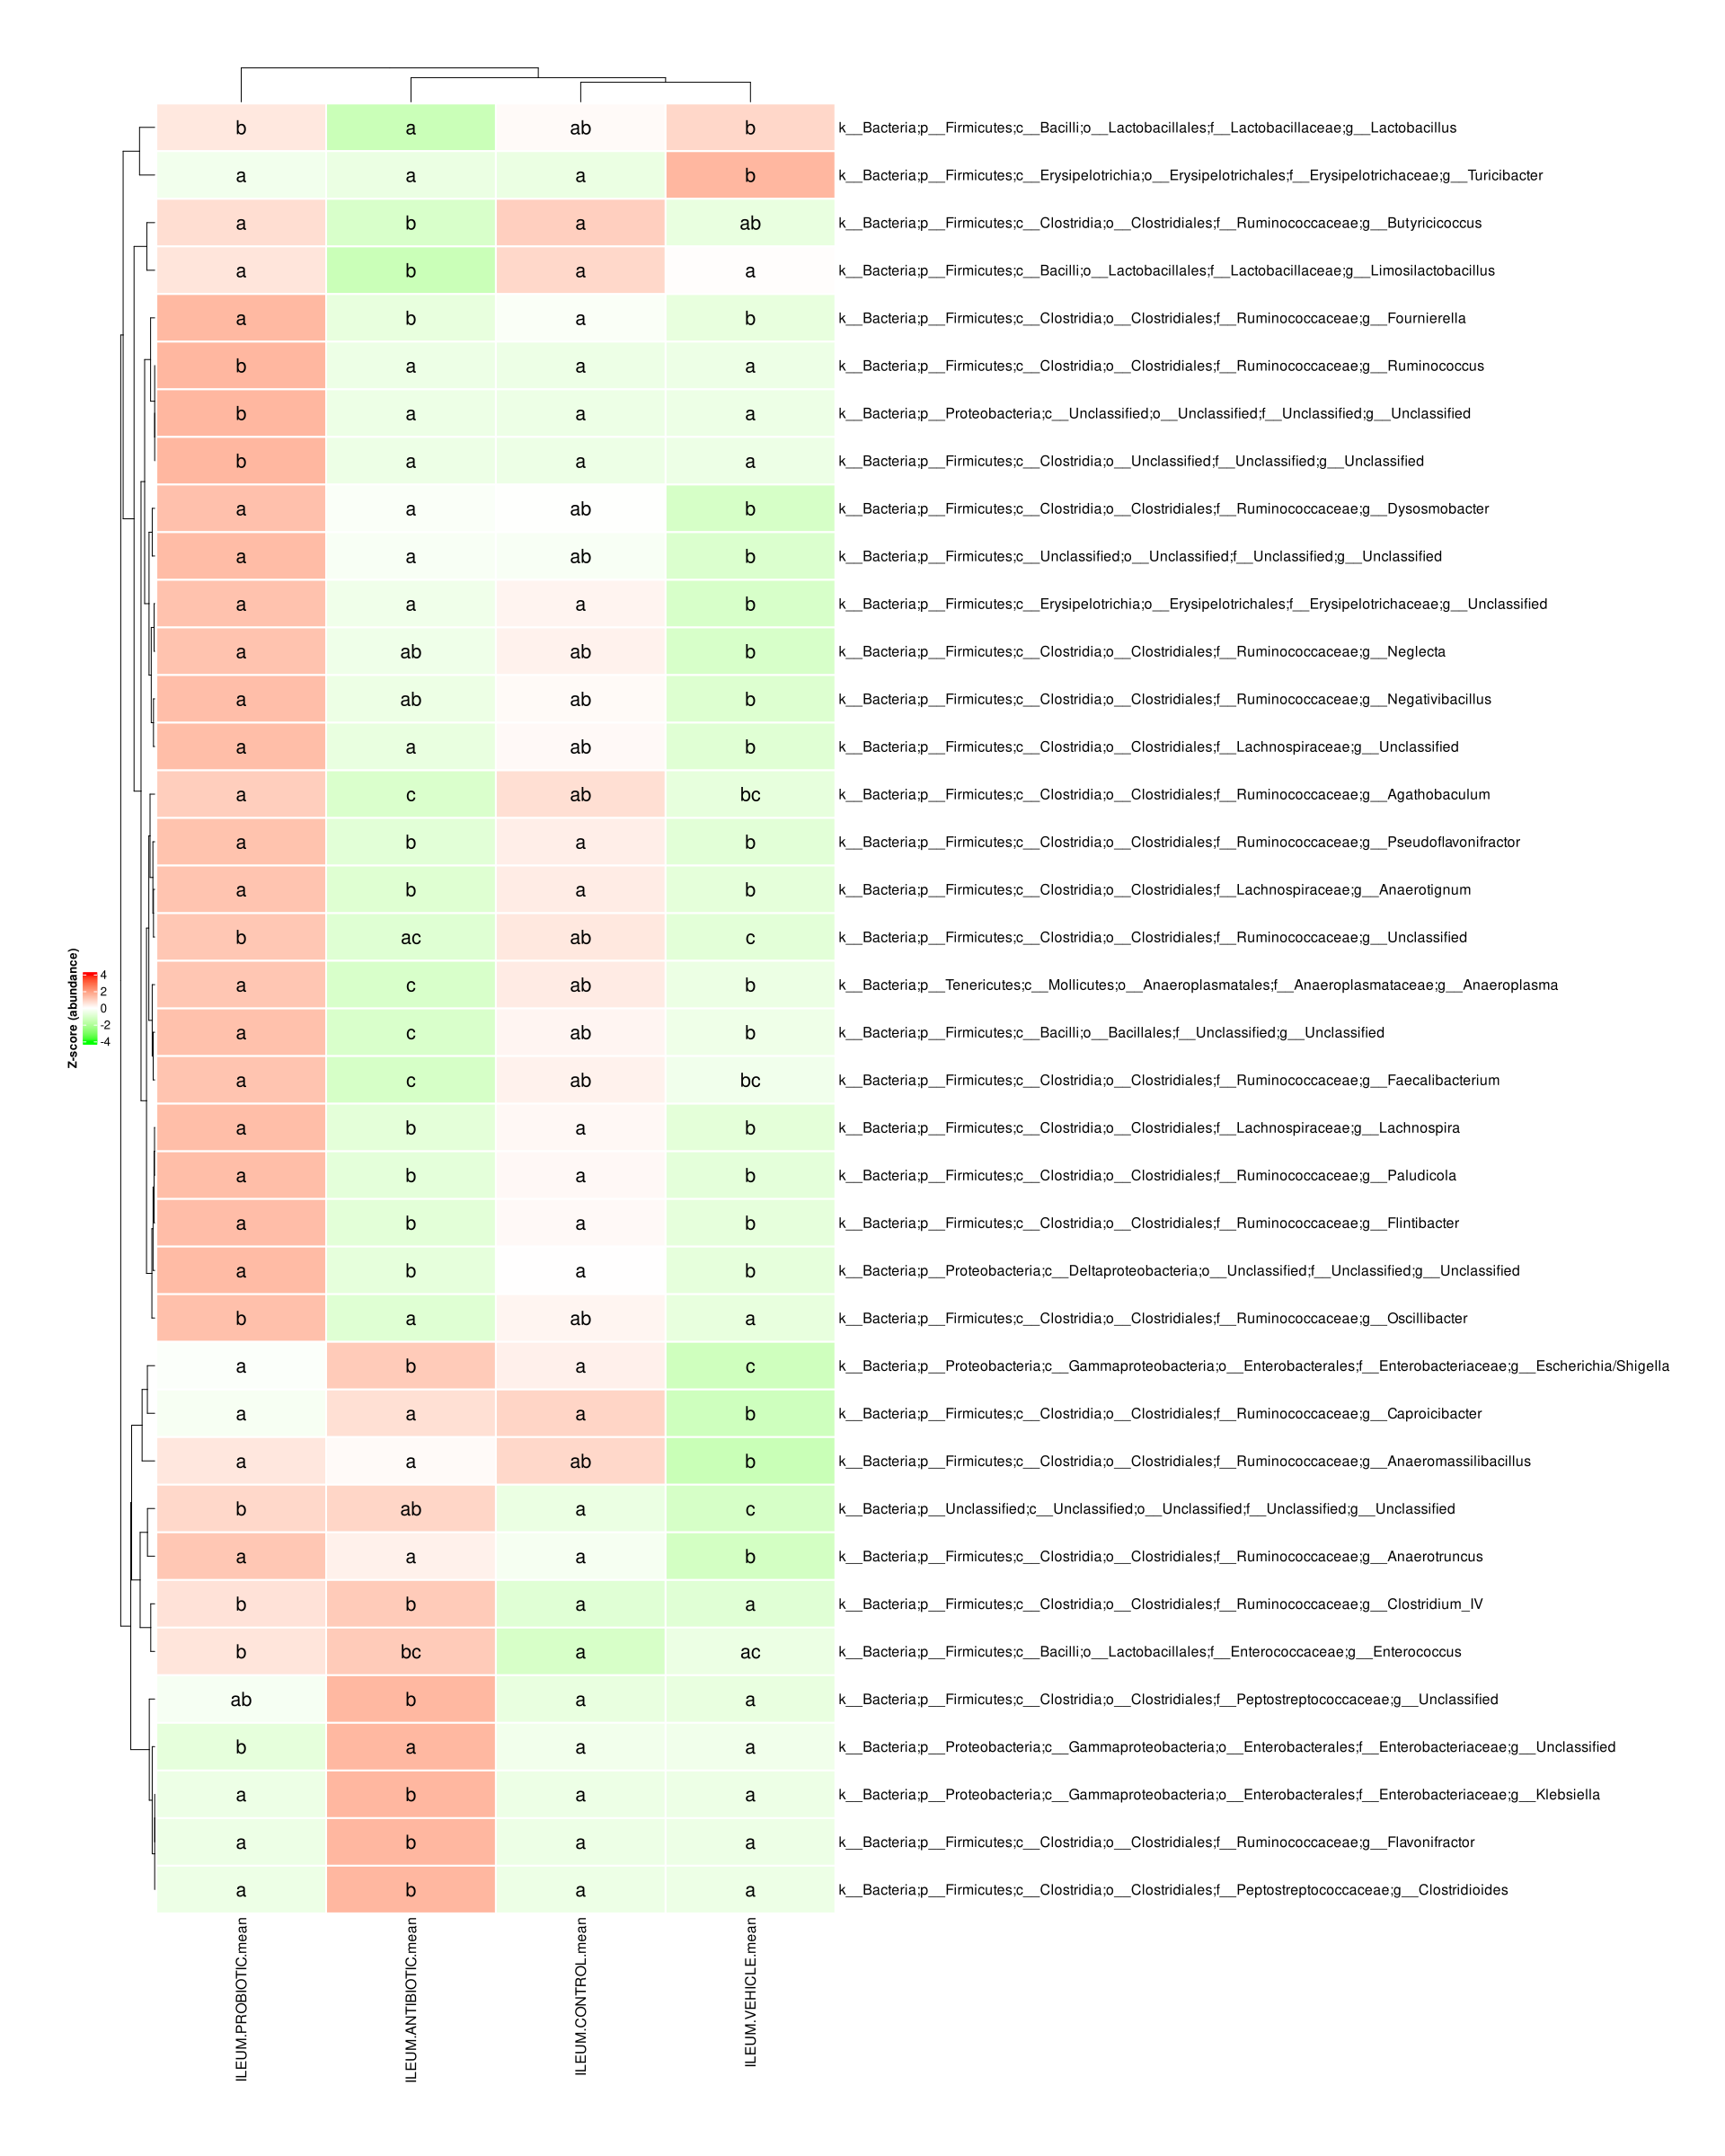
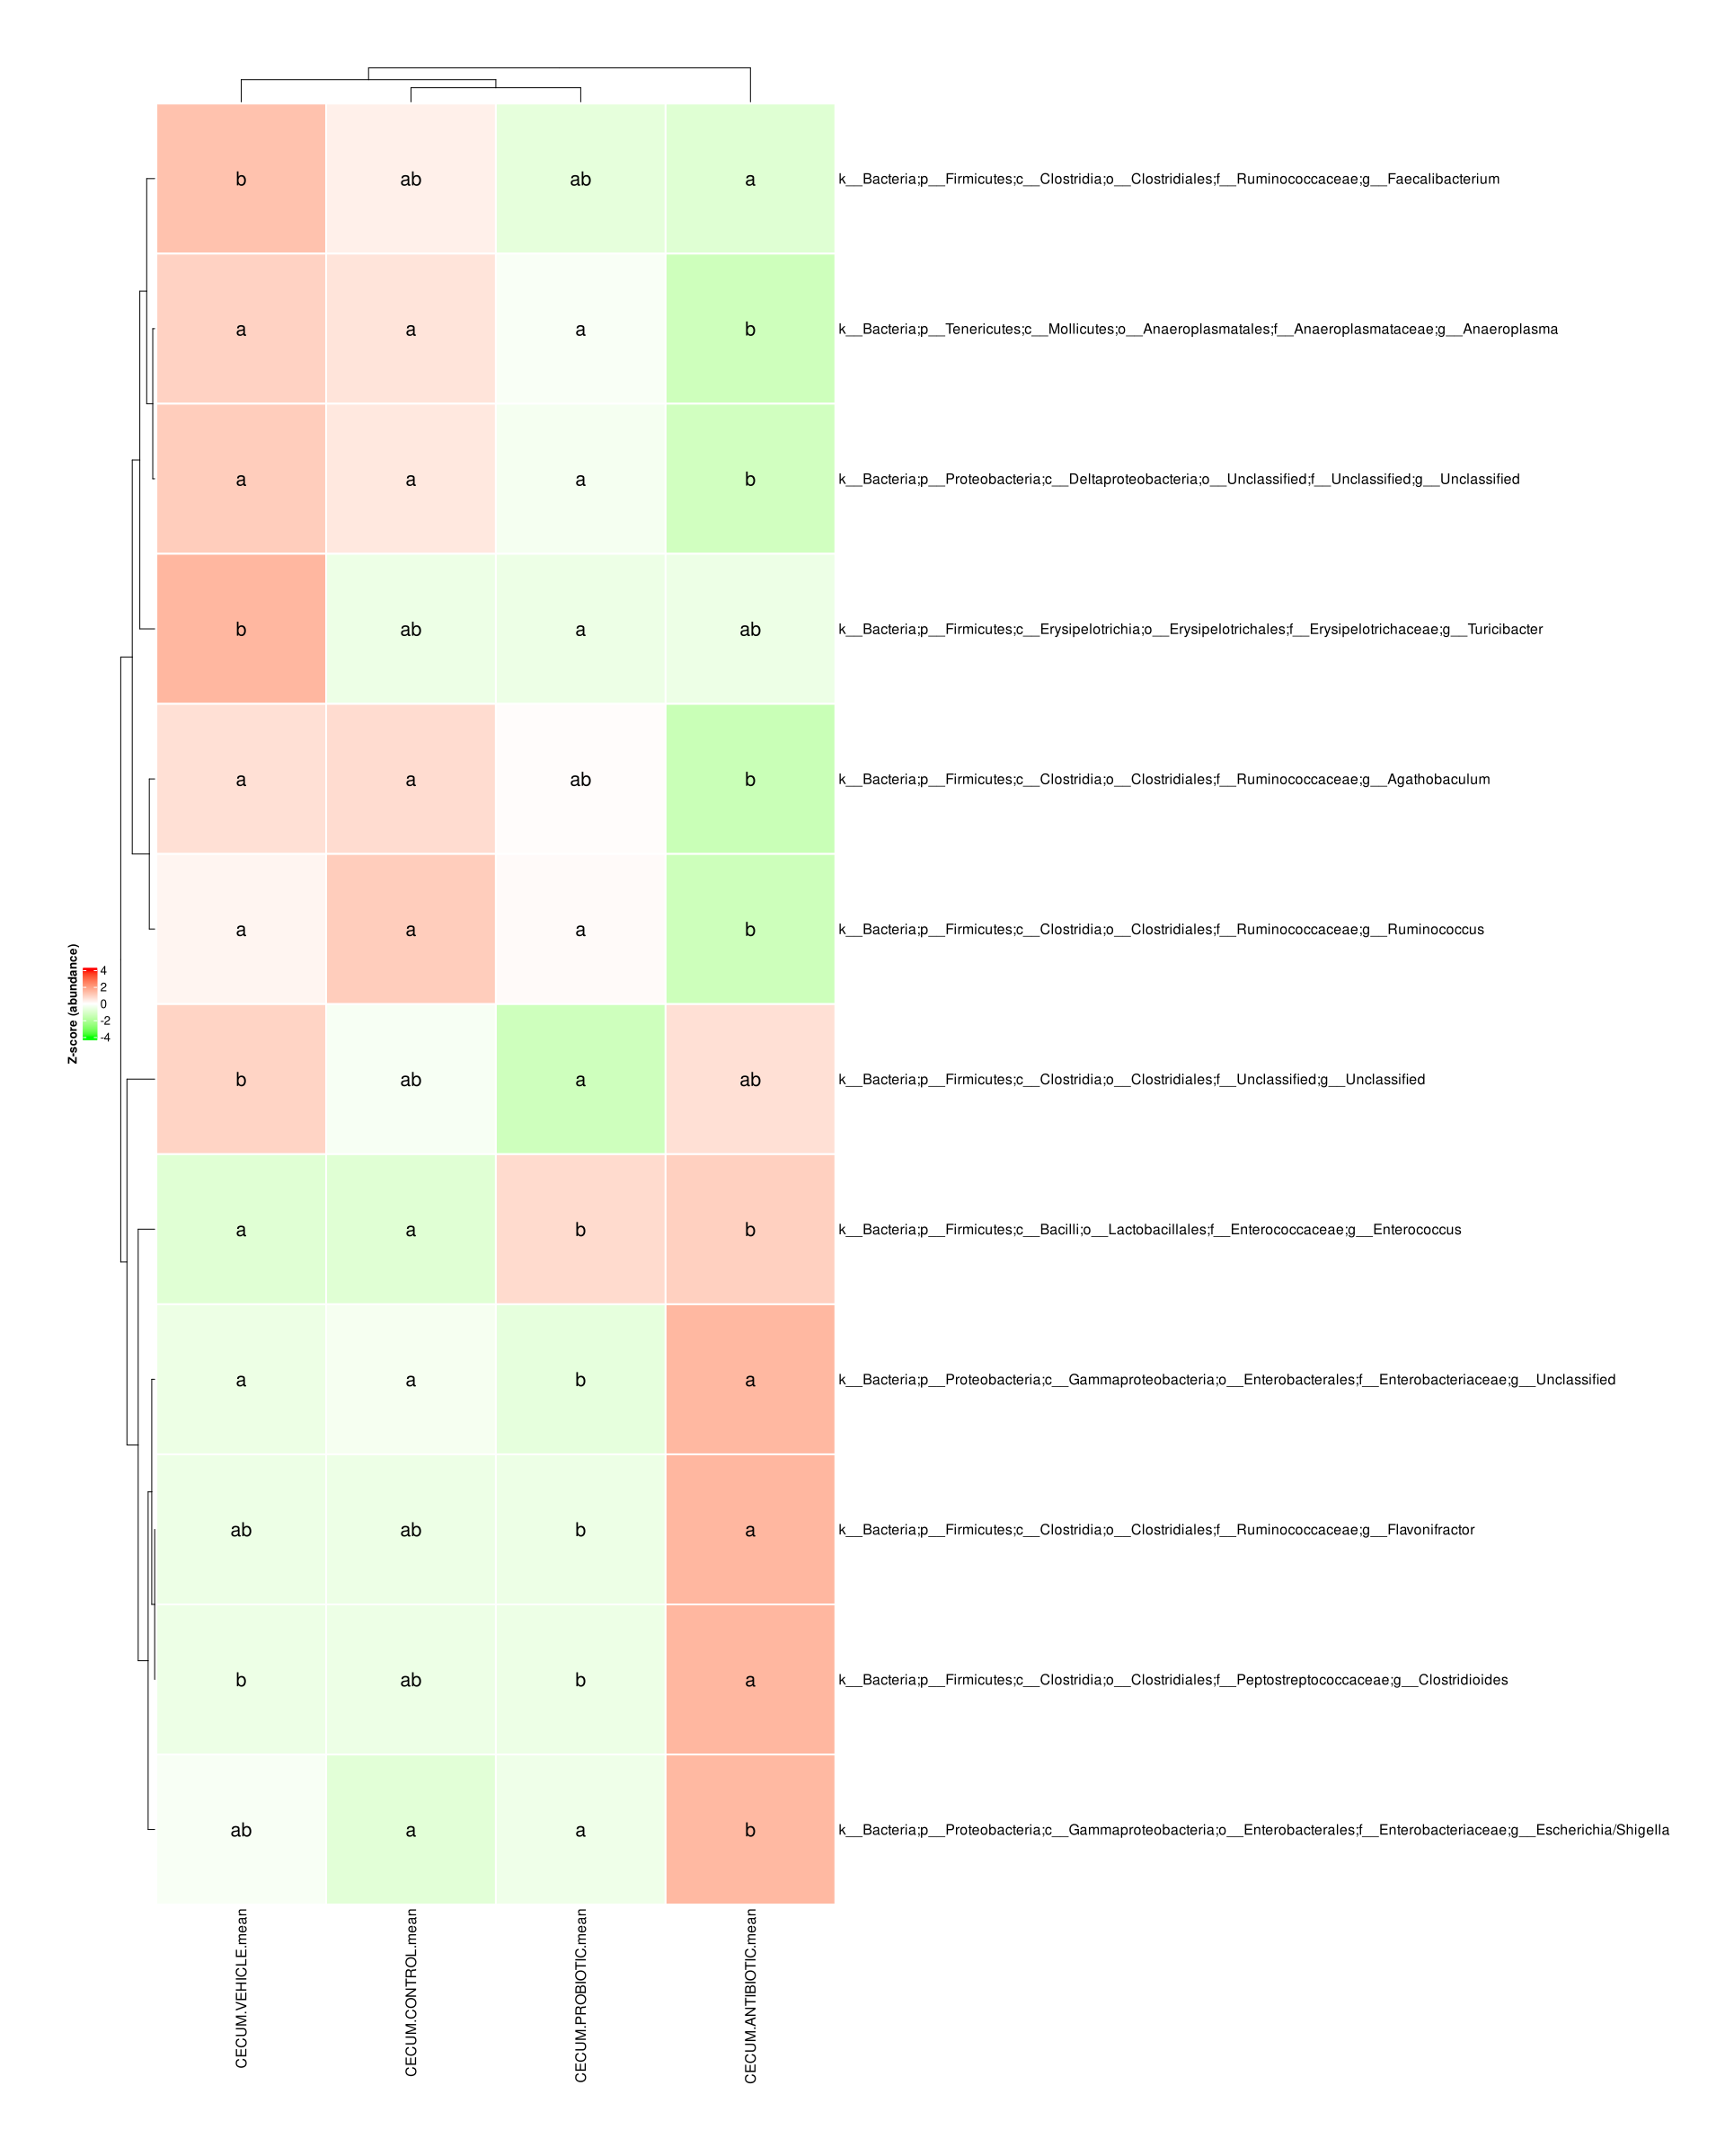
Aqui podemos fazer uma comparação da abundância dos taxa (gêneros) entre as microbiotas nos segmentos do intestino sob um determinado tratamento, para os dois pools de amostras de aves, considerando machos e fêmeas. A avaliação da abundância diferencial foi realizada com o pacote DESeq2 v1.34.0, a partir da matrix após a filtragem dos taxa com valores de abundância baixos de acordo com a abundância mínima de 10 em ao menos 1 amostra. A normalização dos dados foi realizada seguida de transformação logarítmica. A abundância diferencial foi avaliada aplicando modelo linear generalizado (Generalized Linear Model - GLM) considerando um ajuste a uma distribuição de probabilidade binomial negativa (Negative Binomial GLM). As significâncias dos coeficientes do GLM (gêneros) foi avaliada com o teste de Wald (Generalized Linear Model Likelihood Ratio Test). Os dados tiveram seus níveis descritivos de significância estatística (p-values) ajustados (adjusted p-values) pela taxa de falsas descobertas (False Discovery Rate, ou FDR). Os dados de abundância das amostras exibidos e suas médias foram previamente transformados utlizando a transformação Log2 (função normTransform() do pacote DESeq2 com parâmetro f=log2 e pc=1 para indicar pseudocontagem de 1).
Essa comparação foi realizada utilizando como entrada a aglomeração dos ASVs em gêneros e foram filtrados 114 gêneros, sem que os grupos de amostras tivessem a soma das abundâncias mínima de 10. Assim como bibliotecas sem um mínimo de soma de abundâncias (10), também foram removidas (). Um Heatmap foi montado com os gêneros que tiveram alguma diferença de abundância significativa (adj-p-value < 0.1) a partir da comparação de abundância diferencial entre os grupos em cada tempo (Figure 14). Os dendrogramas foram construídos a partir do algoritmo de agrupamento hierárquico com distância euclideana e método de ligação ward.D2. Os valores para o gráfico foram escalados para z-score. Os valores relacionados ao cálculo de diferença de abundância foram inseridos em planilhas do arquivo Excel a seguir:
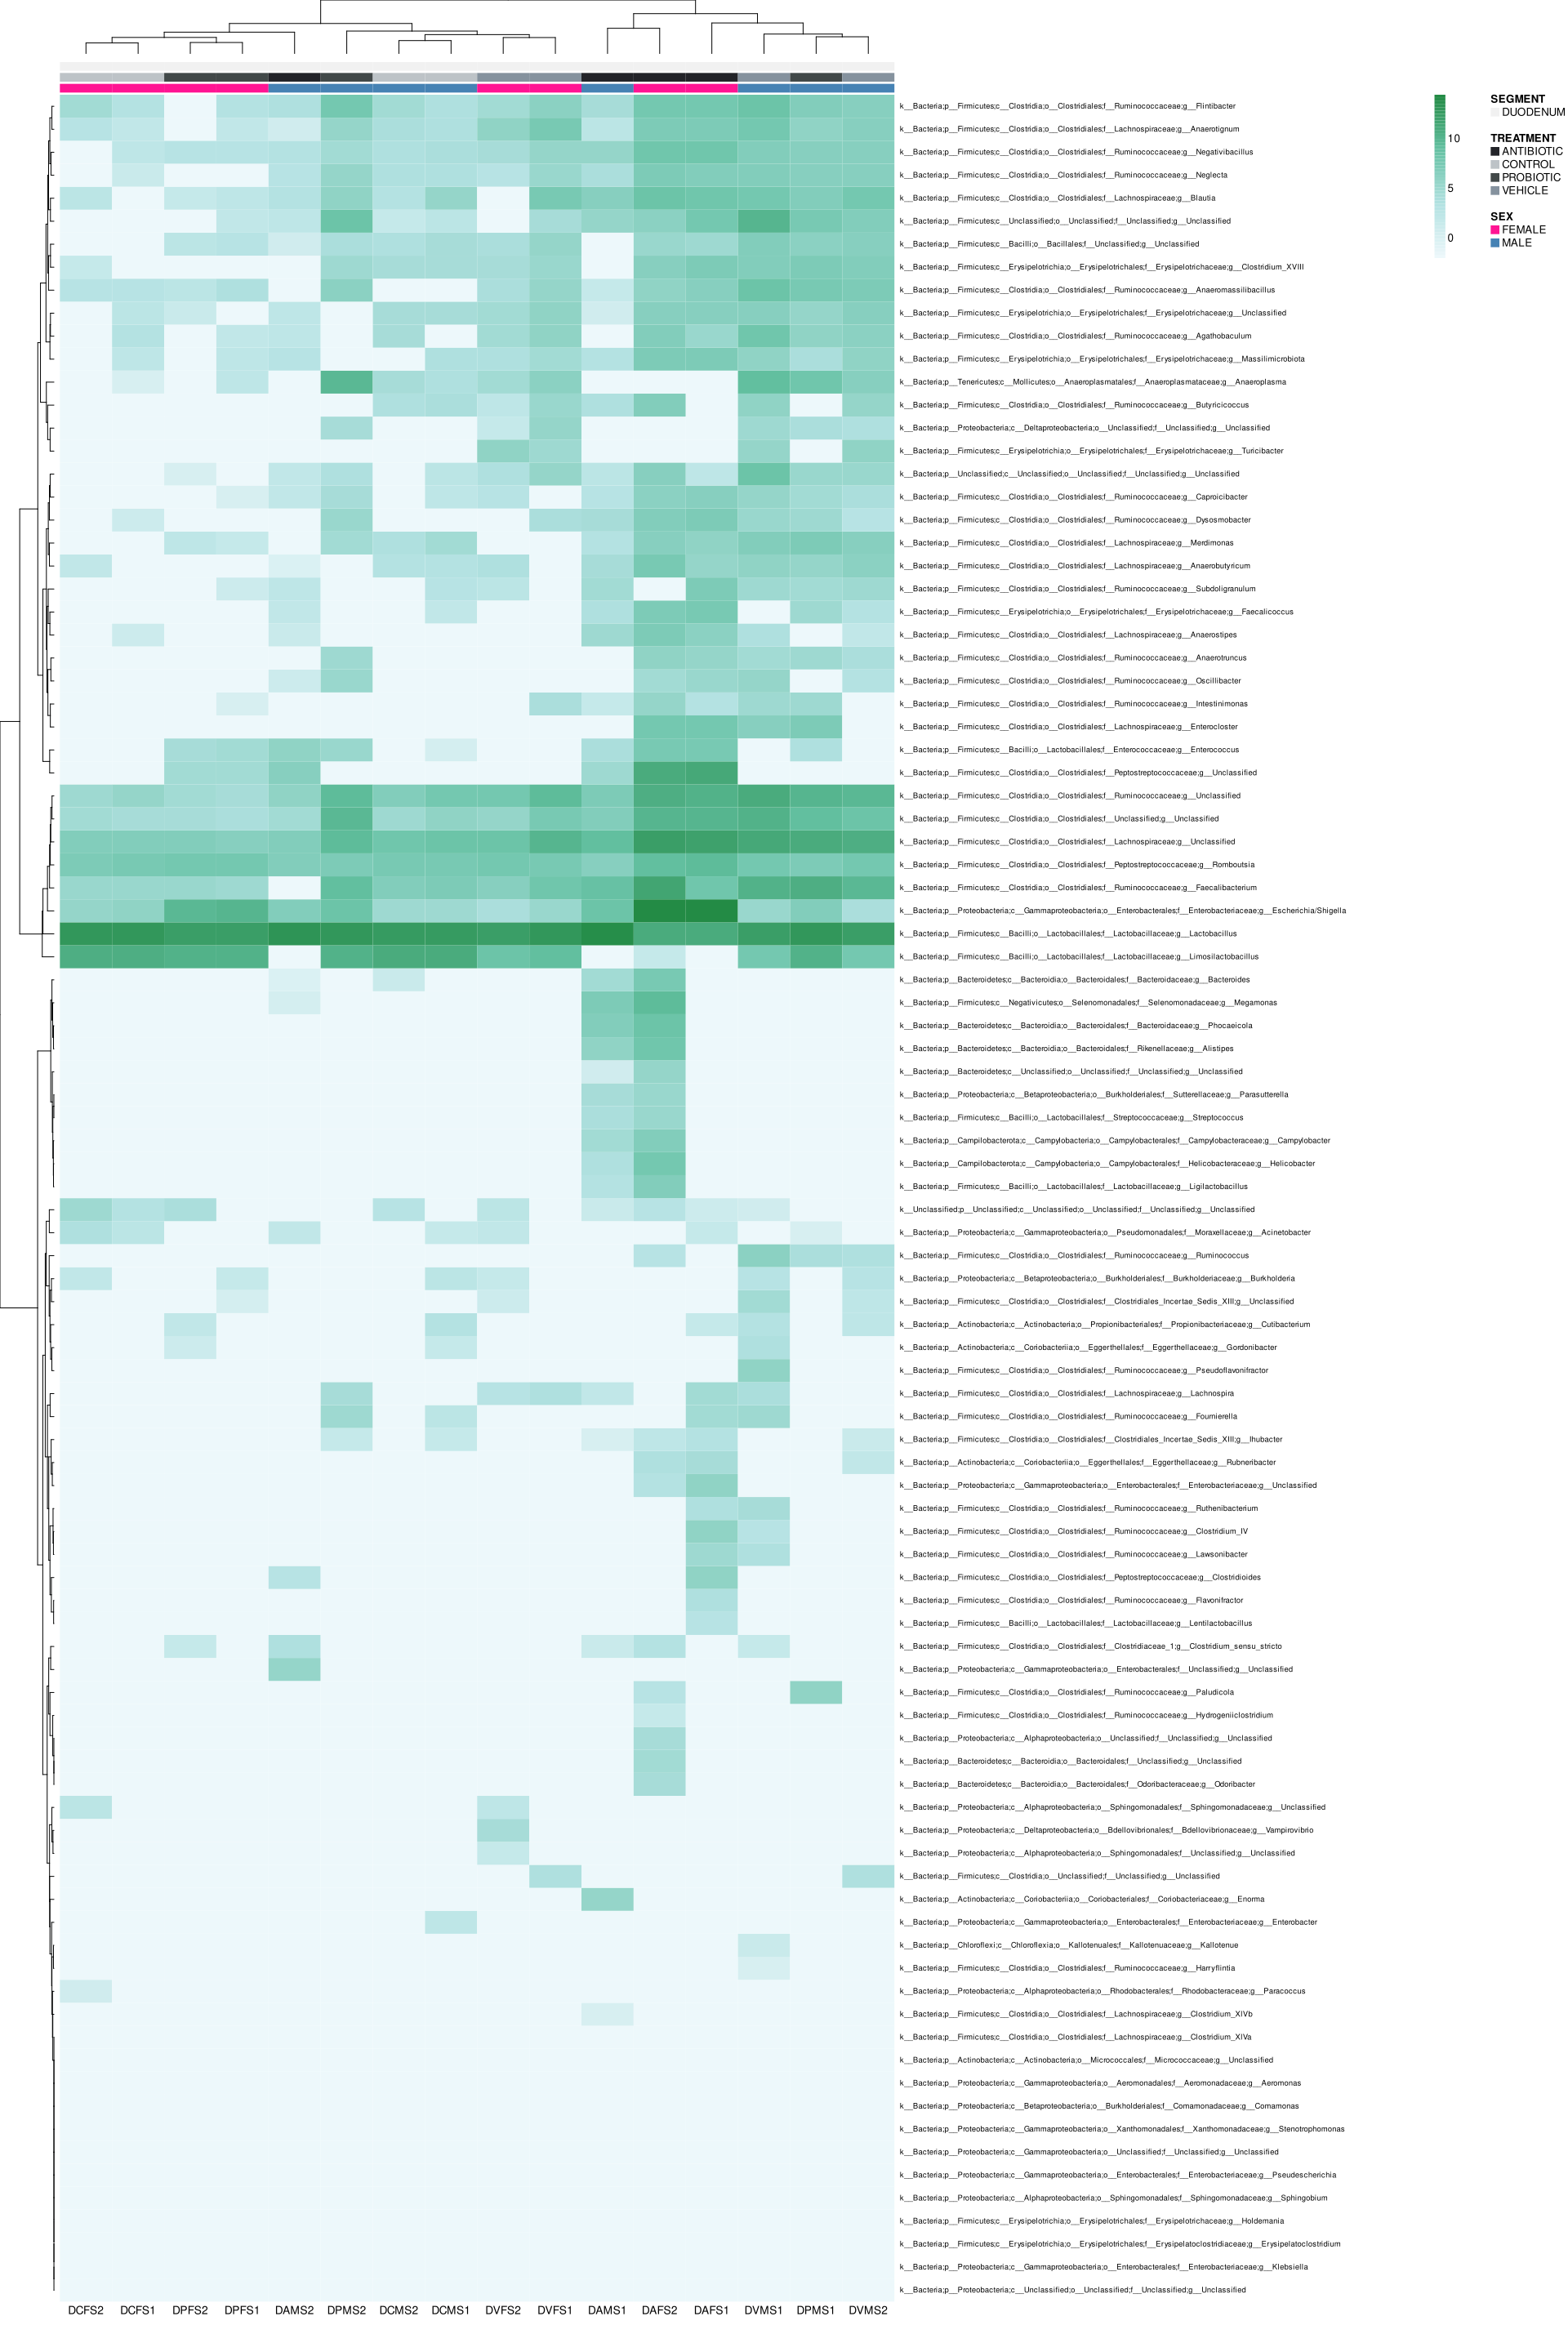
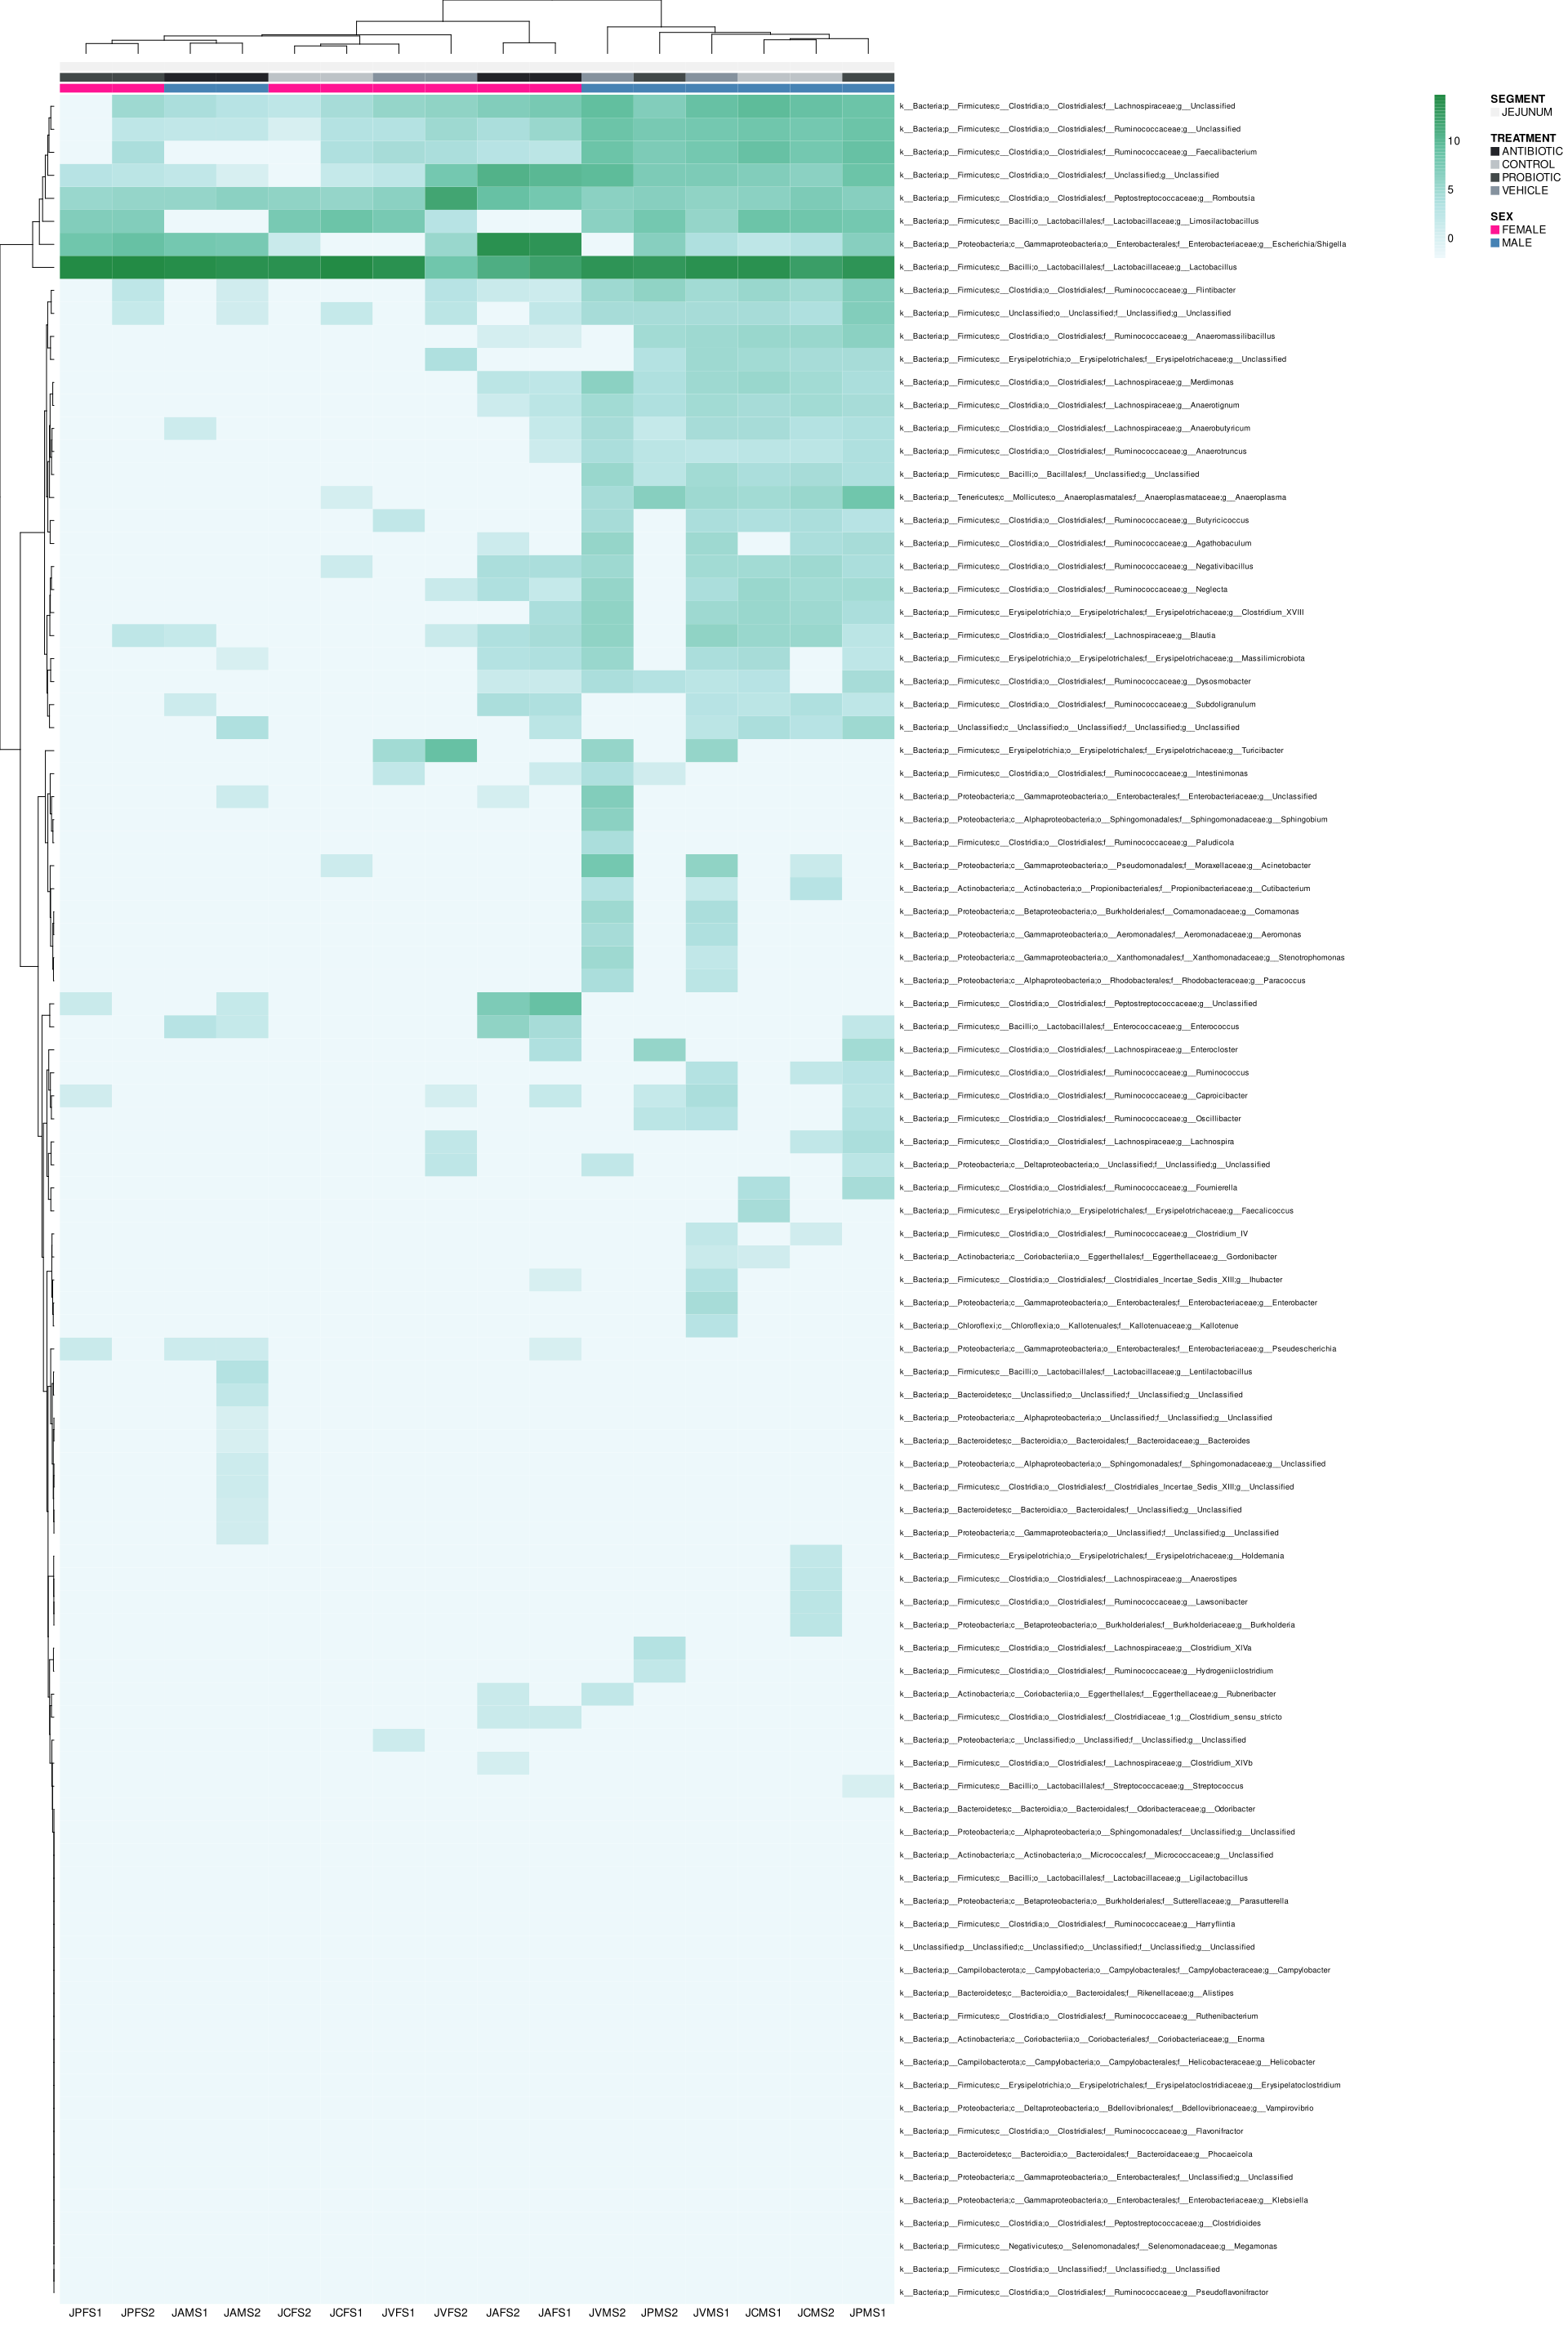
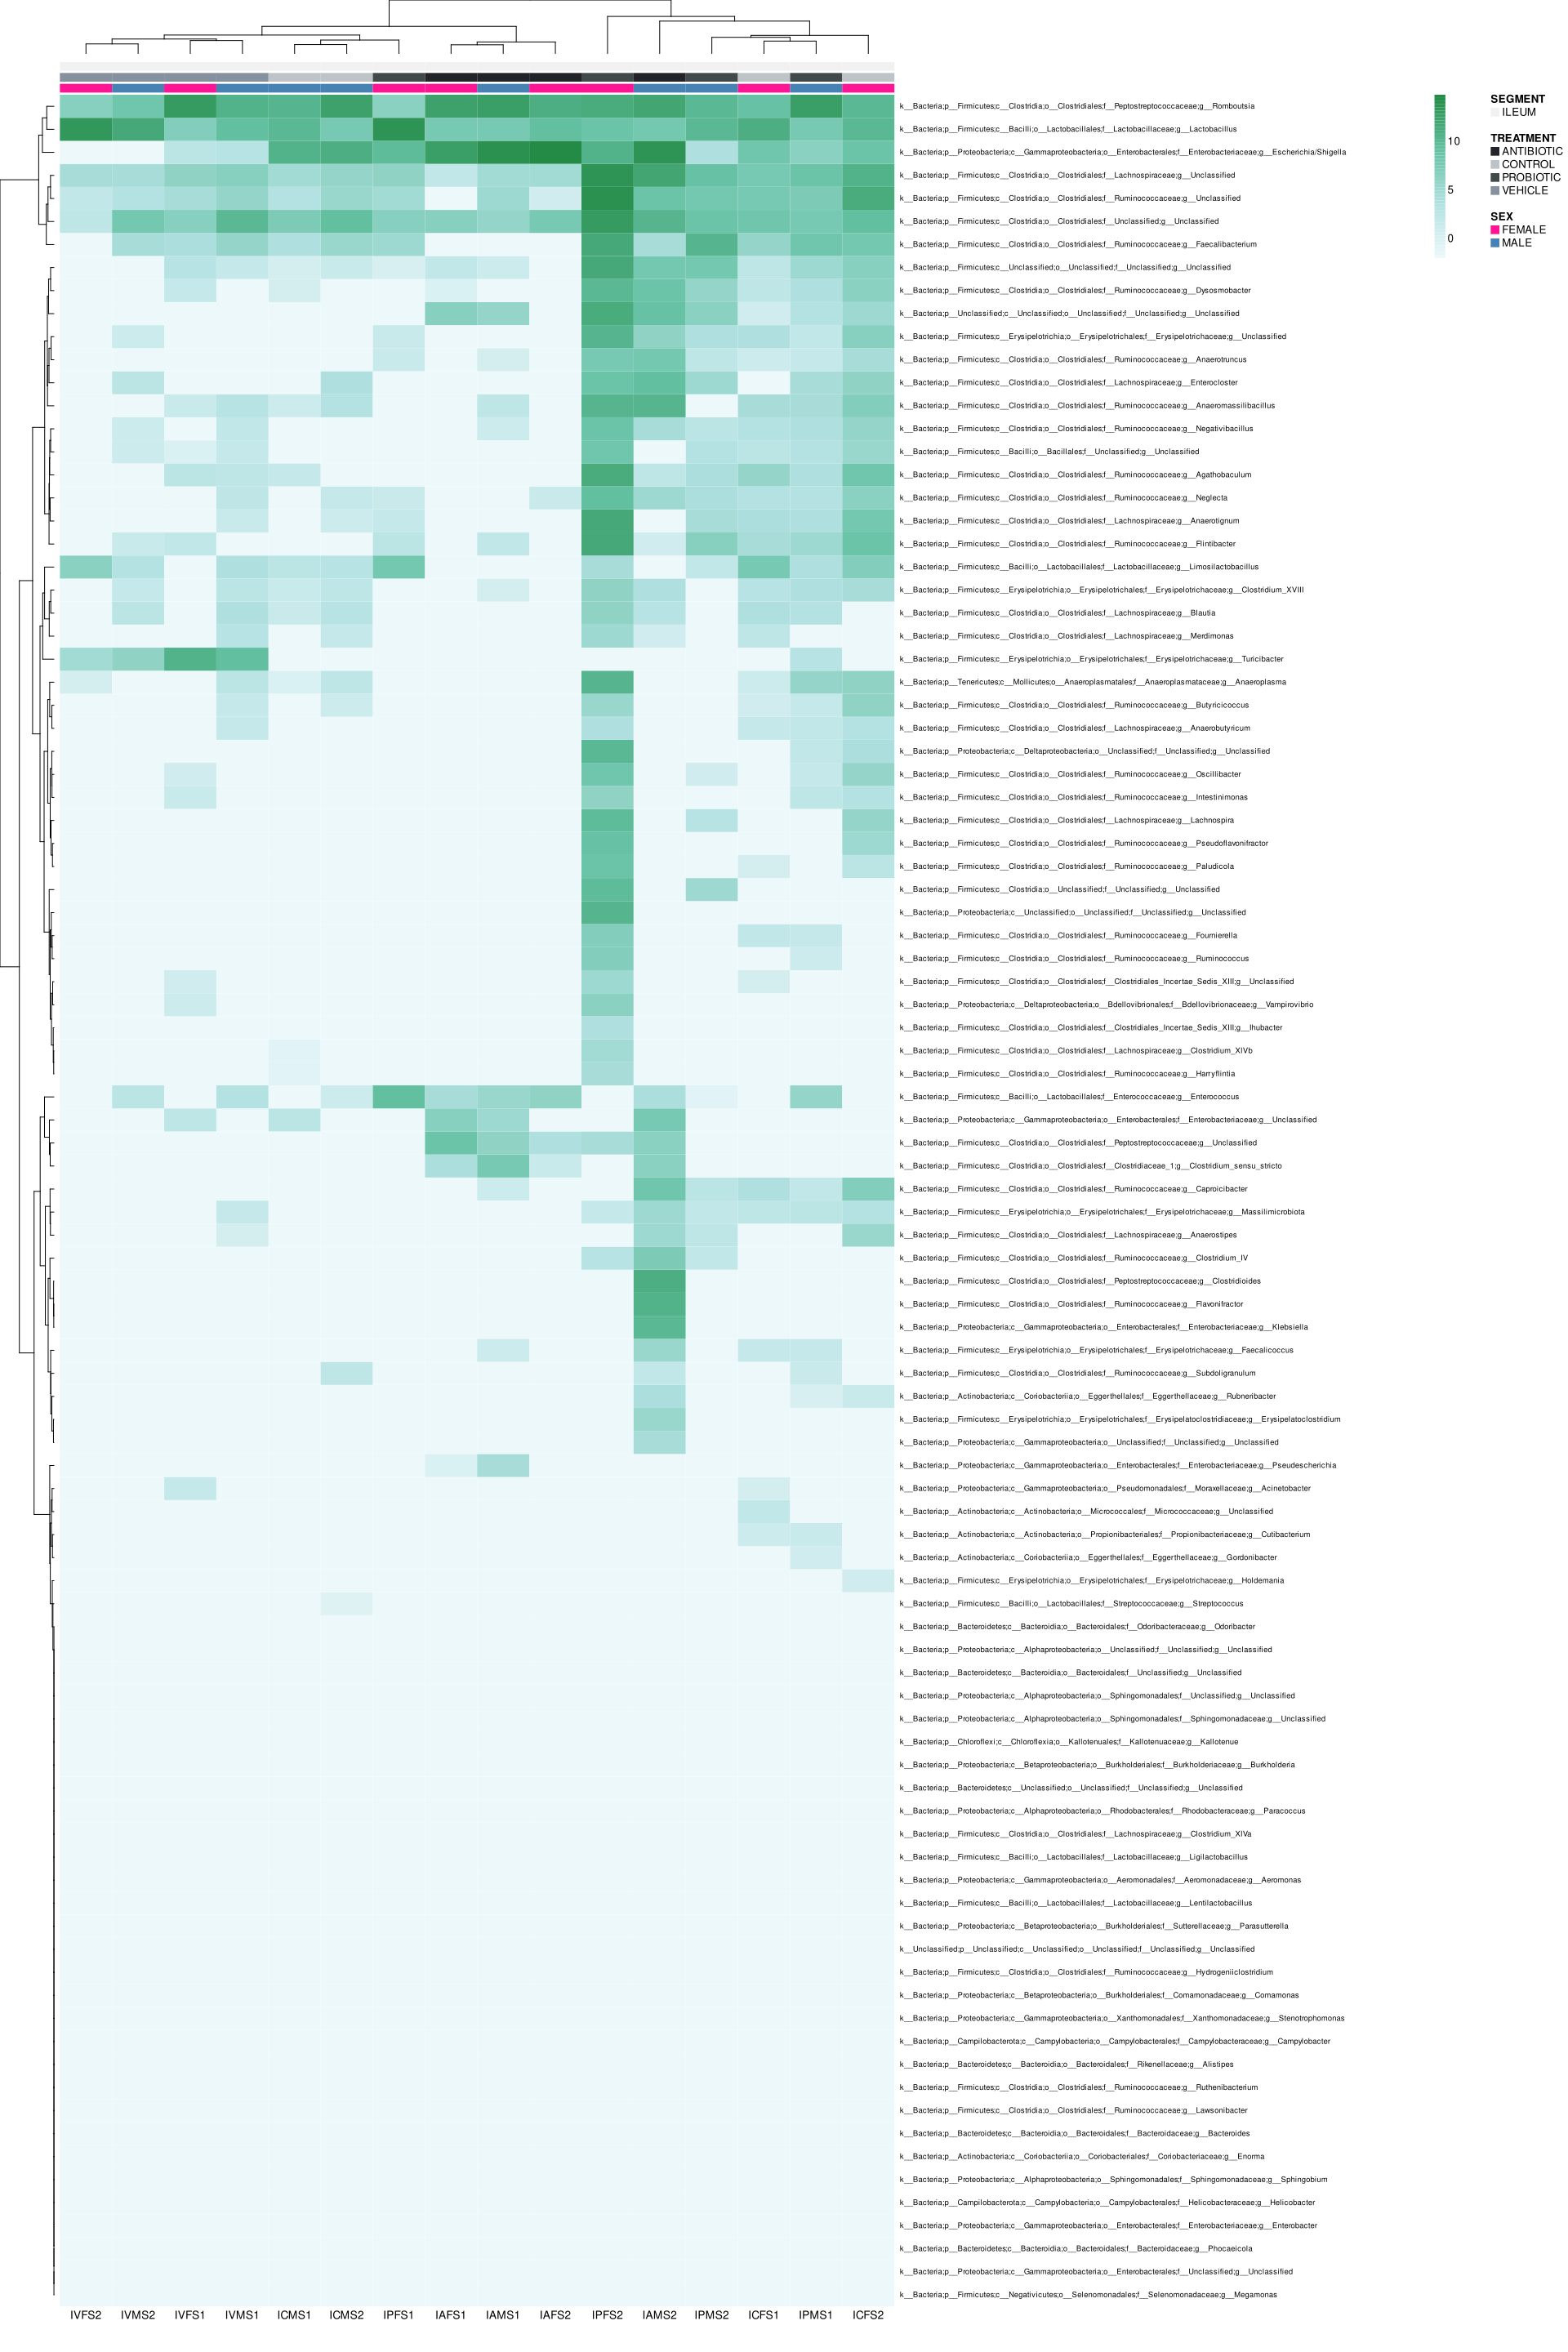
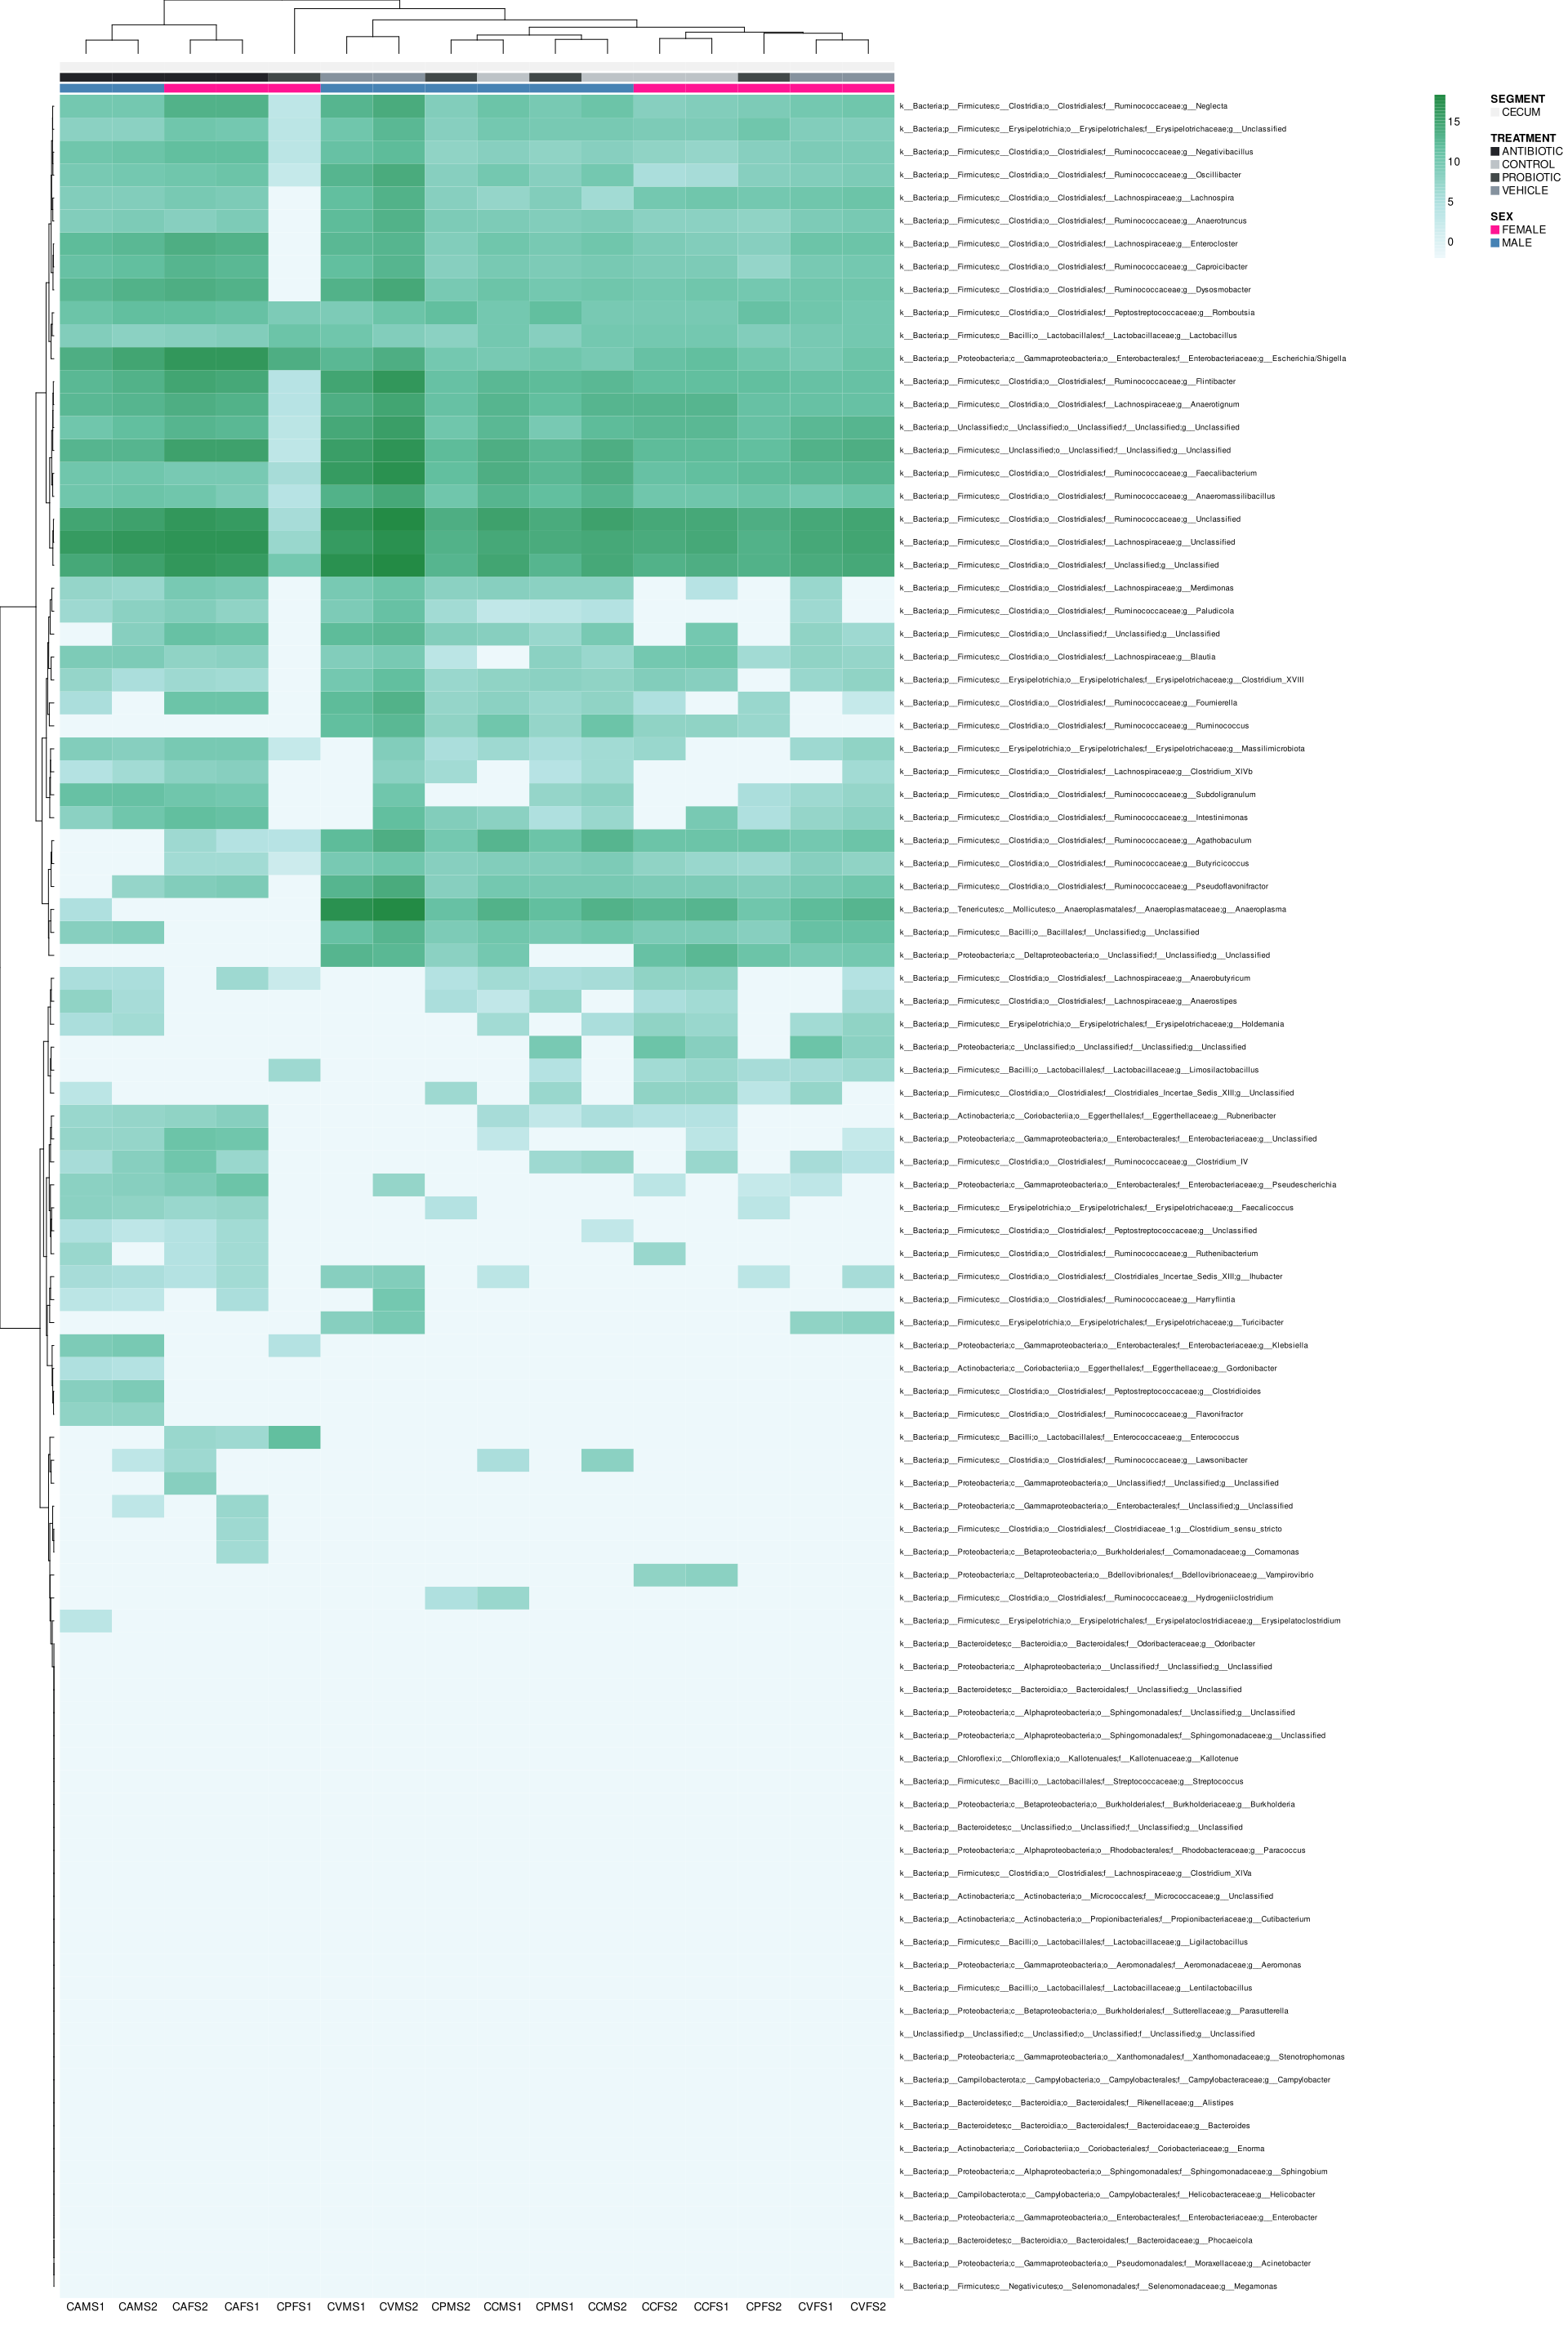
Outros heatmaps foram gerados com anotações das amostras (grupos) e com todas os gêneros que tiveram abundância normalizada e possuem mais do que zero de contagem nas amostras de cada tempo (Figure 15). Os dados de abundância das amostras exibidos nesses heatmaps foram previamente transformados utlizando a transformação VST (variance stabilizing transformation) desconsiderando o desenho experimental (função varianceStabilizingTransformation() do pacote DESeq2 com parâmetro blind=TRUE). Os dendrogramas foram construídos a partir do algoritmo de agrupamento hierárquico com distância euclideana e método de ligação ward.D2.
References
Callahan, Ben J., Kris Sankaran, Julia A. Fukuyama, Paul J. McMurdie, and Susan P. Holmes. 2016. “Bioconductor Workflow for Microbiome Data Analysis: From Raw Reads to Community Analyses.” F1000Research 5 (November): 1492. https://doi.org/10.12688/f1000research.8986.2.
Footnotes
esparsa: valores espalhados, ou seja, com muitos zeros na matriz de abundâncias.↩︎